As 6 melhores ferramentas de scraping, do iniciante ao muito avançado

O web scraping consiste em extrair os dados de um site de forma estruturada. Seis ferramentas comparadas, da mais acessível à mais técnica: Google Sheets, Web Scraper, Apify, Captain Data, Scrapy e Puppeteer, para escolher conforme o volume de linhas a coletar e o nível técnico.

Maxime Ben Bouaziz
Maxime Ben Bouaziz
CEO Salesdorado, IA & Sales Tech
13 de outubro de 2020, atualizado em 10 de novembro de 2026, 1 min de leitura
Ver todas as ferramentas

O web scraping consiste em extrair os dados de um site de forma estruturada, para organizá-los em uma tabela: montar um arquivo de prospecção, enriquecer uma base existente, monitorar os preços de um concorrente. A ferramenta certa depende de duas coisas: o volume de linhas a coletar e o seu nível técnico.

Conforme a sua necessidade:

  • algumas centenas de linhas, sem sair de uma planilha: Google Sheets e sua função IMPORTXML;
  • vários milhares de linhas sem escrever código: a extensão Web Scraper;
  • dados de sites conhecidos (Google Maps, Instagram, TikTok…) com um scraper já pronto: Apify;
  • fichas de pessoas e empresas B2B atualizadas, por API: Captain Data;
  • um scraper sob medida em Python: Scrapy;
  • páginas que só aparecem em JavaScript: Puppeteer, que controla um navegador de verdade.

Antes de abrir uma ferramenta, pense no copiar e colar. Uma tabela exibida em uma página muitas vezes pode ser colada direto no Excel ou no Google Sheets, e o assunto está resolvido em um minuto. Eu mesmo me peguei várias vezes procurando um padrão complicado em uma tabela quando um copiar e colar resolvia: automatizar só faz sentido se a operação se repete ou se o volume exige.

As seis ferramentas abaixo estão ordenadas da mais acessível à mais técnica.
As 6 ferramentas, lado a lado

# Logos ferramenta Nota Preço Ideal para
01 Captain Data 4.2/5 ★ 59,99 € As equipes que querem dados B2B atualizados sobre pessoas e empresas, por API, sem manter um scraper Visitar o site
02 Google Sheets 4.0/5 ★ Gratuito Os scrapings pequenos, abaixo de 1.000 linhas, feitos diretamente em uma planilha Visitar o site
03 Web Scraper 4.1/5 ★ US$ 40 Os novatos que encaram grandes volumes (mais de 1.000 linhas) sem escrever código Visitar o site
04 Apify 4.0/5 ★ US$ 19 Raspar entre 1.000 e 10.000 linhas com bots pré-configurados, sem gerenciar um servidor Visitar o site
05 Scrapy 4.3/5 ★ Gratuito Os desenvolvedores Python que querem fazer scraping rápido, localmente, nos próprios servidores ou na nuvem Visitar o site
06 Puppeteer 4.4/5 ★ Gratuito Os grandes projetos em páginas geradas em JavaScript, quando a fonte de dados continua inacessível Visitar o site
01

Captain Data

4.2/5 A partir de 59,99 €

Ideal para: As equipes que querem dados B2B atualizados sobre pessoas e empresas, por API, sem manter um scraper

+ Pontos fortes
  • Cuida da parte técnica: você se concentra no dado
  • Enriquecimento de contatos e empresas B2B (pessoas, empresas, busca)
  • Busca compatível com os filtros do LinkedIn Sales Navigator
  • Tarifas decrescentes conforme o volume
− Pontos fracos
  • Cobrança por crédito com mínimo de 2.500 créditos, cerca de 150 € por mês
  • Virou uma API de dados: não é mais uma ferramenta de scraping no-code
  • Nem e-mail nem telefone nas fichas
★ Captain Data em resumo

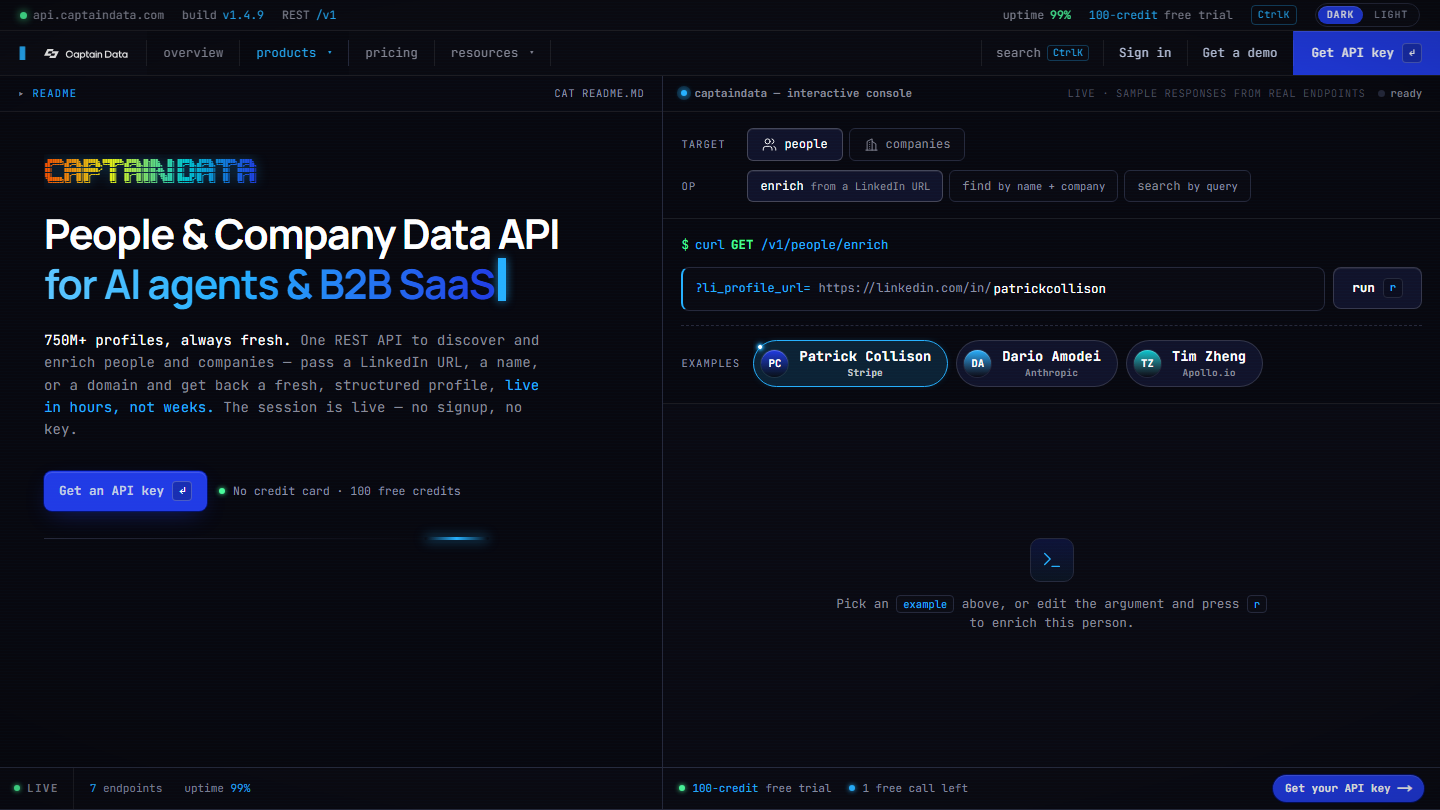
Página inicial do Captain Data: “People & Company Data API for AI agents & B2B SaaS”, com um console que enriquece um perfil a partir de uma URL do LinkedIn

O Captain Data foi por muito tempo uma ferramenta de automação no-code, com cenários prontos para rodar no LinkedIn, no Sales Navigator ou em diretórios. O fornecedor mudou de rumo: hoje o Captain Data é uma API de dados sobre pessoas e empresas, pensada para fornecedores de software B2B e agentes de IA. O fornecedor anuncia mais de 750 milhões de perfis.

Na prática, você envia à API uma URL do LinkedIn, um nome e uma empresa, ou um domínio, e recebe uma ficha estruturada: cargo, trajetória, empresa, porte, setor. A busca de pessoas e empresas reaproveita os filtros do Sales Navigator. O Captain Data, em compensação, não fornece nem e-mail nem telefone: é preciso complementar com uma ferramenta de enriquecimento de contatos.

Para uma equipe comercial, é uma ferramenta a ser conectada por um desenvolvedor, ou por uma ferramenta de automação, a um CRM ou a um aplicativo próprio. O scraping em si, a manutenção dele e o bloqueio pelos sites ficam por conta do fornecedor.

O nível Bronze sai por 59,99 € a cada 1.000 créditos, cobrados por mês, com compra mínima de 2.500 créditos. Uma ficha enriquecida custa 1 crédito. O teste dá 100 créditos sem cartão de crédito.

02

Google Sheets

4.0/5 A partir de Gratuito

Ideal para: Os scrapings pequenos, abaixo de 1.000 linhas, feitos diretamente em uma planilha

+ Pontos fortes
  • Função IMPORTXML: qualquer elemento de uma página via XPath
  • Utilizável em fluxo, não apenas em lote
  • Abre a porta para processos que atualizam ou enriquecem os dados
  • Gratuito com uma conta do Google
− Pontos fracos
  • Exige conhecer XPath, que se aprende bem rápido
  • Dificilmente viável acima de 1.000 linhas
★ Google Sheets em resumo

Site de Google Sheets: “Planilhas on-line e colaborativas”

O Google Sheets não é uma ferramenta de scraping, mas a função IMPORTXML faz dele uma. Você informa o endereço de uma página e uma consulta XPath, e a célula se preenche com os elementos encontrados: títulos, preços, links, o conteúdo de uma tag específica.

Na prática, você cola uma lista de URLs em uma coluna e escreve a fórmula uma vez na coluna ao lado, depois arrasta para baixo. É o que usamos no lead scorer da Salesdorado para obter o título da página inicial do domínio associado ao e-mail de um contato. A sintaxe XPath exige uma hora de aprendizado e vai servir com todas as ferramentas mais avançadas desta lista.

Como os dados ficam em uma planilha, você pode encadear etapas: limpar, cruzar com outra aba, enviar para um CRM. O Google recalcula as funções IMPORT a cada hora, o que basta para acompanhar uma página que muda pouco. O método mostra seus limites assim que o site pede login ou exibe o conteúdo em JavaScript: a fórmula devolve então uma célula vazia.

Gratuito com uma conta do Google.

03

Web Scraper

4.1/5 A partir de US$ 40

Ideal para: Os novatos que encaram grandes volumes (mais de 1.000 linhas) sem escrever código

+ Pontos fortes
  • Ferramenta no-code, sem XPath para escrever
  • Cuida da paginação e das interações com a página
  • Tutoriais fáceis de pegar, mesmo sem ter programado
  • Extensão de navegador gratuita
− Pontos fracos
  • Bem lenta, tanto para configurar quanto para executar
  • Versão Cloud paga: US$ 50 por mês, US$ 40 no anual
★ Web Scraper em resumo

Página inicial do Web Scraper: “Replace your scraping infrastructure”, com o teste gratuito de 7 dias do Web Scraper Cloud

O Web Scraper é uma extensão do Chrome que permite construir um scraper clicando na página, sem escrever código. Ela vai mais longe do que se imagina: paginação, clique em um botão “ver mais”, passagem de uma lista para cada ficha detalhada.

Na prática, você abre o site a ser raspado e depois a aba Web Scraper das ferramentas de desenvolvimento. Você cria um “sitemap”, ou seja, o caminho que a ferramenta vai seguir: a página de lista, o link para cada ficha e depois os campos a capturar na ficha (nome, endereço, telefone). Você inicia a extração, o navegador percorre as páginas diante dos seus olhos e você recupera um arquivo CSV ou Excel. Os tutoriais são fáceis de seguir, mesmo sem nunca ter escrito uma linha de código na vida.

A extensão roda no seu computador: durante um scraping grande, o navegador fica ocupado. O Web Scraper Cloud executa os mesmos sitemaps nos servidores do fornecedor, com agendamento e API. O fornecedor esclarece que a versão Cloud não extrai dados das redes sociais, LinkedIn incluído.

A extensão é gratuita para uso local. O Web Scraper Cloud começa com o plano Project a US$ 50 por mês (US$ 40 no anual), depois o Professional a US$ 100 e o Scale a partir de US$ 200, com teste de 7 dias.

04

Apify

4.0/5 A partir de US$ 19

Ideal para: Raspar entre 1.000 e 10.000 linhas com bots pré-configurados, sem gerenciar um servidor

+ Pontos fortes
  • Biblioteca muito completa de “actors”, bots pré-configurados
  • Nenhuma configuração de servidor para gerenciar, rotação de IP incluída
  • Bots colocados em fluxo via API para atualizar os datasets
  • Plano gratuito
− Pontos fracos
  • Exige uma cultura web razoavelmente boa
  • Pode ficar caro rápido em um projeto que chama muito um mesmo site
★ Apify em resumo

Página inicial do Apify: a busca de Actors e de scrapers prontos para uso para TikTok, Google Maps ou Instagram

O Apify é uma plataforma onde se executam scrapers na nuvem, sem instalar nada. Seu ponto forte é a biblioteca: cerca de 100.000 “Actors”, robôs já prontos para Google Maps, Instagram, TikTok, sites de e-commerce ou qualquer site que se queira percorrer.

Na prática, você procura o Actor que corresponde à sua necessidade, por exemplo “Google Maps Scraper”, preenche um formulário (palavras-chave, cidade, número de resultados) e inicia. Os resultados chegam em uma tabela exportável em CSV, Excel ou JSON. A plataforma cuida dos servidores e da rotação de endereços IP, o que evita ser bloqueado pelo site visado.

Usamos o Apify para construir o email finder da Salesdorado: no nosso uso, os Actors rodavam cerca de dez vezes mais rápido que as mesmas tarefas no PhantomBuster. Os Actors também podem ser disparados por API, para atualizar um conjunto de dados em intervalos regulares. Parte dos Actors é publicada por desenvolvedores independentes: veja a nota e o número de usuários antes de confiar.

O plano gratuito dá US$ 5 de créditos de uso por mês, o bastante para testar. O plano Starter custa US$ 19 por mês, depois o Scale a US$ 199 e o Business a US$ 999.

05

Scrapy

4.3/5 A partir de Gratuito

Ideal para: Os desenvolvedores Python que querem fazer scraping rápido, localmente, nos próprios servidores ou na nuvem

+ Pontos fortes
  • Uma referência para quem gosta de Python
  • Framework muito eficiente e bem documentado
  • Executa localmente, em servidores ou lambdas, ou no Scrapy Cloud
  • Gratuito e de código aberto
− Pontos fracos
  • Limitado em páginas geradas em JavaScript
  • Reservado a quem escreve Python
★ Scrapy em resumo

Página inicial do Scrapy: “The world’s most-used open source data extraction framework”, com um exemplo de crawl em linha de comando

O Scrapy é o framework de referência para scraping em Python. É gratuito, de código aberto e mantido pela empresa Zyte com mais de 500 contribuidores.

Na prática, você escreve uma “spider”, uma classe Python que diz por onde começar, quais links seguir e quais campos capturar em cada página. O Scrapy cuida do resto: requisições em paralelo, fila de espera, novas tentativas em caso de erro, exportação em CSV ou JSON. Você o executa localmente, nos seus servidores ou nas suas lambdas, ou no Scrapy Cloud, a hospedagem oferecida pela Zyte.

O limite dele está nas páginas construídas em JavaScript, cada vez mais frequentes: o Scrapy lê o código HTML devolvido pelo servidor, não a página como o navegador a exibe. Muitas vezes, a página busca seus dados em uma API que pode ser chamada diretamente, e o Scrapy volta a ser a boa solução.

O Scrapy é gratuito. O Scrapy Cloud tem um plano Starter gratuito (uma hora de crawl, dados guardados por 7 dias) e um plano Pro a US$ 9 por mês por unidade.

06

Puppeteer

4.4/5 A partir de Gratuito

Ideal para: Os grandes projetos em páginas geradas em JavaScript, quando a fonte de dados continua inacessível

+ Pontos fortes
  • Passa em praticamente todos os sites, páginas JavaScript incluídas
  • Simples de escrever em NodeJS e notavelmente bem documentado
  • Biblioteca gratuita e de código aberto, mantida pelo Google, que controla o Chrome ou o Firefox
− Pontos fracos
  • Exige conhecimentos prévios
  • Caro de implementar, em tempo ou em dinheiro
★ Puppeteer em resumo

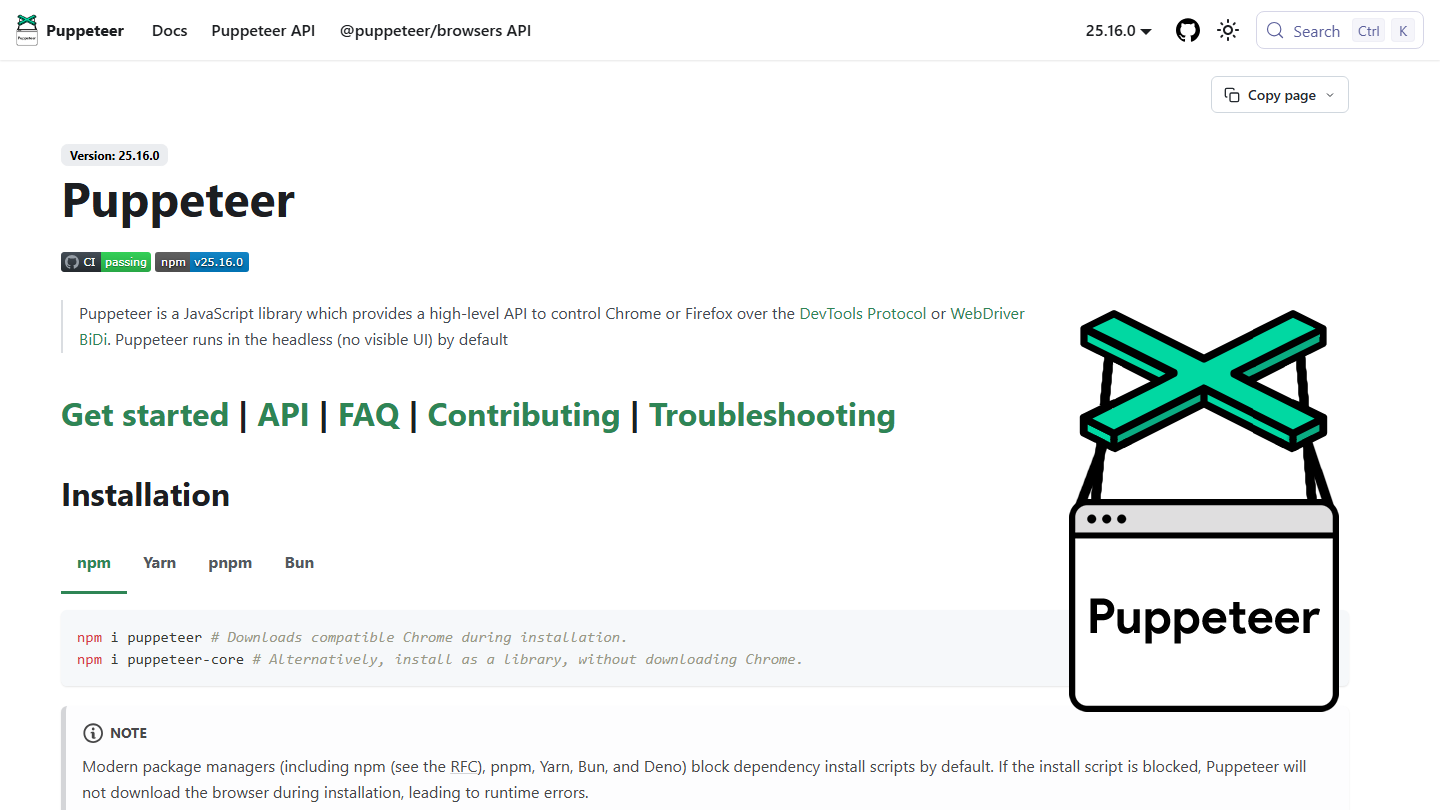
Página inicial da documentação do Puppeteer, biblioteca JavaScript que controla o Chrome ou o Firefox

O Puppeteer é uma biblioteca JavaScript que controla um navegador de verdade, Chrome ou Firefox, a partir de um script. O navegador carrega a página como faria um visitante, JavaScript incluído, e depois o script lê o que é exibido. É a solução de último recurso quando a fonte de dados não pode ser chamada diretamente (na maioria das vezes, ela devolve um erro 403).

Na prática, um script do Puppeteer abre uma página, espera um elemento aparecer, clica, rola a tela, preenche um campo de busca e depois recupera o texto desejado. Na Salesdorado, usamos em NodeJS: é simples de escrever e notavelmente bem documentado. Quem gosta de Python vai preferir o Selenium; o Playwright, de uma equipe da Microsoft, propõe a mesma abordagem em várias linguagens.

Um navegador consome bem mais memória e tempo do que uma simples requisição: cada página custa mais para raspar do que com o Scrapy. Antes de escrever seu script, verifique se já não existe um robô para esse site no Apify. Funciona com bastante frequência e evita dor de cabeça.

O Puppeteer é gratuito e de código aberto, mantido pela equipe de automação do navegador Chrome no Google.

Como escolhemos estas 6 ferramentas?

Cada ferramenta desta seleção foi usada em condições reais pelo nosso time ou por um consultor da Salesdorado, num contexto de sales e marketing B2B. Nenhum ranking feito a partir de um material de marketing. A ordem da lista não é uma classificação: a ferramenta certa depende da sua necessidade.

  1. 01
    Escopo do benchmark

    Identificação ampla das ferramentas do mercado (G2, Capterra, retornos de clientes da Salesdorado, sinais do LinkedIn). Filtragem inicial e depois short-list a partir de um setup de 2 h por ferramenta.

  2. 02
    Condições de teste

    3 a 4 semanas de uso ativo por ferramenta, com dados representativos de um use-case de sales B2B. Quando a ferramenta mira um perfil específico (SDR, AE, Ops, Marketer…), alinhamos o testador de acordo.

  3. 03
    Critérios ponderados

    Para cada categoria, de 5 a 7 eixos ponderados conforme o que está em jogo no segmento: UX, profundidade funcional, integrações nativas, suporte, pricing em escala, conformidade (LGPD, segurança) e qualidade do roadmap.

  4. 04
    Independência

    Nenhuma ferramenta é avaliada em troca de pagamento. Os links de parceiros (afiliação) são marcados como tais e não influenciam a nota. As ferramentas que não são parceiras entram quando seu lugar no ranking se justifica.

  5. 05
    Atualização

    O ranking é revisado a cada 6 a 12 meses ou a cada release importante de uma ferramenta citada. A data da última verificação aparece no topo do artigo.

As perguntas que nos fazem sem parar.

É possível fazer web scraping sem ferramenta?

Sim, com um simples copiar e colar. Dá para copiar todas as tabelas da Wikipedia para um arquivo do Excel ou uma planilha do Google: códigos postais, nomes comuns ou códigos telefônicos saem em um minuto. O método é muito rápido, mas muito limitado.

Como fazer scraping de uma página web com o Google Sheets?

Com a função =importxml e uma consulta XPath. Por exemplo, =importxml(“https://salesdorado.com/automatisation/meilleurs-outils-webscraping/”, “//h2”) recupera todos os títulos H2 da página. O método se torna dificilmente viável acima de 1.000 linhas.

Qual ferramenta de scraping escolher sem saber programar?

O Web Scraper é uma ferramenta no-code, bastante simples de usar, que cuida da paginação e das interações com a página, sem XPath para escrever. Em compensação, é bem lenta, tanto para configurar quanto para executar.

Como fazer scraping de páginas geradas em JavaScript?

Procure primeiro a fonte de dados diretamente na aba “Network” do navegador. Se ela não puder ser chamada, resta passar por um navegador: Puppeteer em NodeJS ou Selenium para quem prefere Python.

É melhor executar o scraping localmente ou na nuvem?

Se você chama muitos sites, poucas vezes cada um, rode tudo localmente com uma boa velocidade de Internet. Se você chama um único site muitas vezes, olhe para o AWS Lambda para cuidar da rotação de IPs.

★ A conversa, 0 comentários

O que a comunidade diz.

Markdown básico, moderação em 24 h
Carregando…

    Na mesma categoria