Las 6 mejores herramientas de scraping, de principiante a muy avanzado

El web scraping consiste en extraer los datos de un sitio web de forma estructurada. Seis herramientas comparadas, de la más accesible a la más técnica: Google Sheets, Web Scraper, Apify, Captain Data, Scrapy y Puppeteer, para elegir según el volumen de filas por obtener y el nivel técnico.

Maxime Ben Bouaziz
Maxime Ben Bouaziz
CEO Salesdorado, IA & Sales Tech
13 de octubre de 2020, actualizado el 10 de noviembre de 2026, 1 min de lectura
Ver todas las herramientas

El web scraping consiste en extraer los datos de un sitio web de forma estructurada, para organizarlos en una tabla: armar un archivo de prospección, enriquecer una base existente, vigilar los precios de un competidor. La herramienta adecuada depende de dos cosas: el volumen de filas por obtener y tu nivel técnico.

Según tu necesidad:

  • unos cientos de filas, sin salir de una hoja de cálculo: Google Sheets y su función IMPORTXML;
  • varios miles de filas sin escribir código: la extensión Web Scraper;
  • datos de sitios conocidos (Google Maps, Instagram, TikTok…) con un scraper ya escrito: Apify;
  • fichas de personas y empresas B2B actualizadas, por API: Captain Data;
  • un scraper a la medida en Python: Scrapy;
  • páginas que solo se muestran en JavaScript: Puppeteer, que controla un navegador de verdad.

Antes de abrir una herramienta, piensa en copiar y pegar. Una tabla mostrada en una página suele pegarse tal cual en Excel o Google Sheets, y el asunto queda resuelto en un minuto. Yo mismo me he sorprendido varias veces buscando un patrón complicado sobre una tabla cuando un copiar y pegar bastaba: automatizar solo tiene sentido si la operación se repite o si el volumen lo exige.

Las seis herramientas de abajo están ordenadas de la más accesible a la más técnica.
Los 6 herramientas, lado a lado

# Logos herramienta Nota Precio Ideal para
01 Captain Data 4.2/5 ★ 59,99 € Los equipos que quieren datos B2B actualizados de personas y empresas, por API, sin mantener un scraper Visitar el sitio
02 Google Sheets 4.0/5 ★ Gratis Los scrapings pequeños, de menos de 1000 filas, hechos directamente en una hoja de cálculo Visitar el sitio
03 Web Scraper 4.1/5 ★ US$ 40 Los novatos que abordan grandes volúmenes (más de 1000 filas) sin escribir código Visitar el sitio
04 Apify 4.0/5 ★ US$ 19 Scrapear entre 1000 y 10 000 filas con bots preconfigurados, sin gestionar un servidor Visitar el sitio
05 Scrapy 4.3/5 ★ Gratis Los desarrolladores de Python que quieren scrapear rápido, en local, en sus servidores o en la nube Visitar el sitio
06 Puppeteer 4.4/5 ★ Gratis Los proyectos grandes sobre páginas generadas en JavaScript, cuando la fuente de datos sigue siendo inaccesible Visitar el sitio
01

Captain Data

4.2/5 Desde 59,99 €

Ideal para: Los equipos que quieren datos B2B actualizados de personas y empresas, por API, sin mantener un scraper

+ Fortalezas
  • Se encarga de lo técnico: te concentras en el dato
  • Enriquecimiento de contactos y empresas B2B (personas, empresas, búsqueda)
  • Búsqueda compatible con los filtros de LinkedIn Sales Navigator
  • Tarifas decrecientes con el volumen
− Debilidades
  • Facturación por créditos con un mínimo de 2500 créditos, unos 150 € al mes
  • Se convirtió en una API de datos: ya no es una herramienta de scraping no-code
  • Ni email ni teléfono en las fichas
★ Captain Data en resumen

Página de inicio de Captain Data: “People & Company Data API for AI agents & B2B SaaS”, con una consola que enriquece un perfil a partir de una URL de LinkedIn

Captain Data fue durante mucho tiempo una herramienta de automatización no-code, con escenarios listos para ejecutar en LinkedIn, Sales Navigator o directorios. El proveedor cambió de rumbo: hoy Captain Data es una API de datos sobre personas y empresas, pensada para los proveedores de software B2B y los agentes de IA. El proveedor anuncia más de 750 millones de perfiles.

En concreto, le envías a la API una URL de LinkedIn, un nombre y una empresa, o un dominio, y recibes una ficha estructurada: cargo, trayectoria, empresa, tamaño, sector. La búsqueda de personas y empresas retoma los filtros de Sales Navigator. Eso sí, Captain Data no entrega ni email ni teléfono: hay que completarlo con una herramienta de enriquecimiento de datos de contacto.

Para un equipo comercial, es una herramienta que debe conectar un desarrollador, o una herramienta de automatización, a un CRM o a una aplicación propia. El scraping en sí, su mantenimiento y el bloqueo por parte de los sitios quedan a cargo del proveedor.

El nivel Bronze cuesta 59,99 € por 1000 créditos, facturados al mes, con una compra mínima de 2500 créditos. Una ficha enriquecida cuesta 1 crédito. La prueba da 100 créditos sin tarjeta de crédito.

02

Google Sheets

4.0/5 Desde Gratis

Ideal para: Los scrapings pequeños, de menos de 1000 filas, hechos directamente en una hoja de cálculo

+ Fortalezas
  • Función IMPORTXML: cualquier elemento de una página mediante XPath
  • Utilizable en flujo, no solo por lotes
  • Abre la puerta a procesos que actualizan o enriquecen los datos
  • Gratis con una cuenta de Google
− Debilidades
  • Requiere conocer XPath, que se aprende bastante rápido
  • Difícilmente viable más allá de 1000 filas
★ Google Sheets en resumen

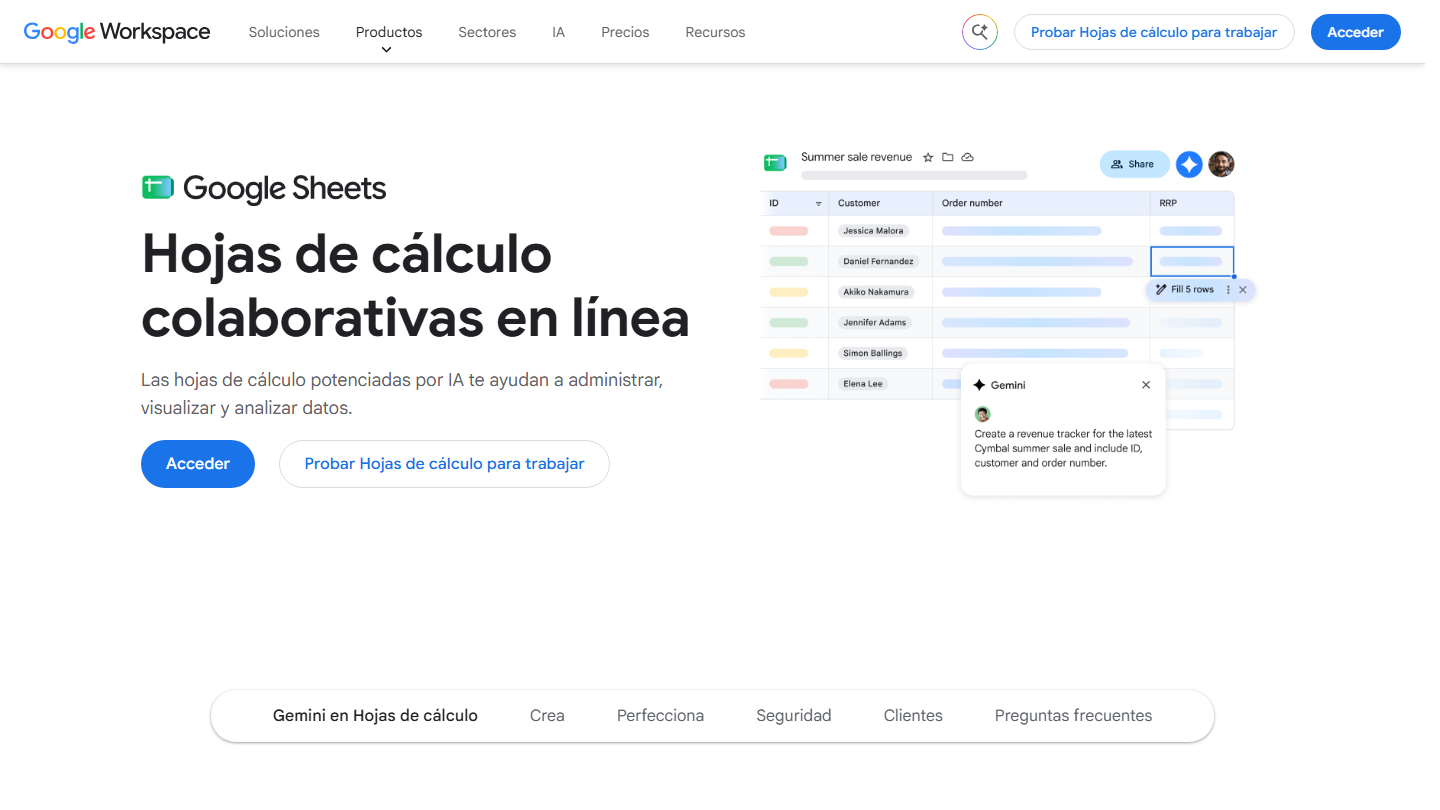
Sitio web de Google Sheets: “Hojas de cálculo colaborativas en línea”

Google Sheets no es una herramienta de scraping, pero su función IMPORTXML la convierte en una. Le das la dirección de una página y una consulta XPath, y la celda se llena con los elementos encontrados: títulos, precios, enlaces, el contenido de una etiqueta específica.

En concreto, pegas una lista de URL en una columna y escribes la fórmula una vez en la columna vecina, luego la arrastras hacia abajo. Es lo que usamos en el lead scorer de Salesdorado para obtener el título de la página de inicio del dominio asociado al email de un contacto. La sintaxis XPath requiere una hora de aprendizaje, y te servirá con todas las herramientas más avanzadas de esta lista.

Como los datos se quedan en una hoja de cálculo, puedes encadenar pasos: limpiarlos, cruzarlos con otra pestaña, enviarlos a un CRM. Google recalcula las funciones IMPORT cada hora, lo que basta para seguir una página que cambia poco. El método muestra sus límites en cuanto el sitio pide iniciar sesión o muestra su contenido en JavaScript: la fórmula devuelve entonces una celda vacía.

Gratis con una cuenta de Google.

03

Web Scraper

4.1/5 Desde US$ 40

Ideal para: Los novatos que abordan grandes volúmenes (más de 1000 filas) sin escribir código

+ Fortalezas
  • Herramienta no-code, sin XPath que escribir
  • Gestiona la paginación y las interacciones con la página
  • Tutoriales fáciles de seguir, incluso sin haber programado
  • Extensión de navegador gratuita
− Debilidades
  • Bastante lenta, tanto para configurar como para ejecutar
  • Versión Cloud de pago: US$ 50 al mes, US$ 40 en anual
★ Web Scraper en resumen

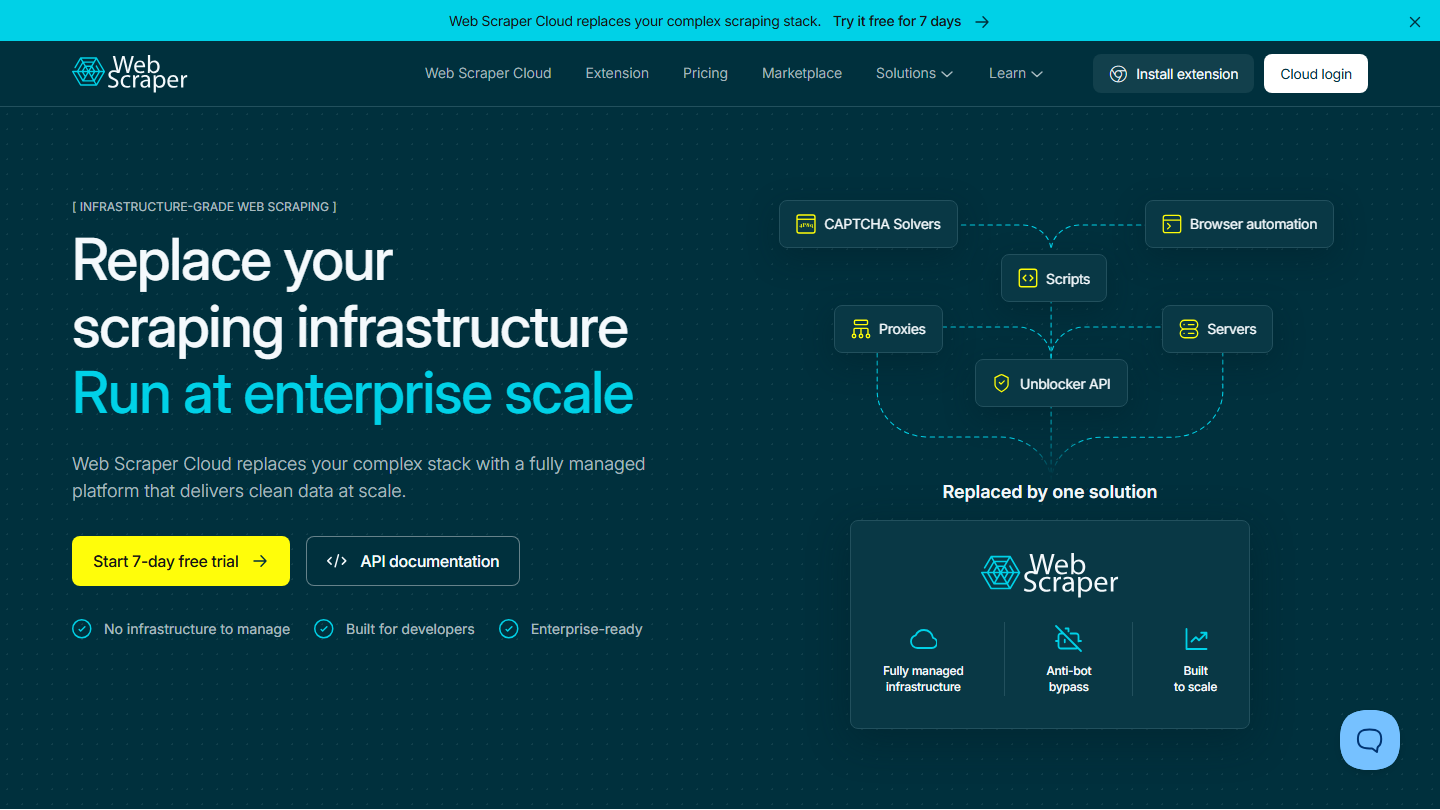
Página de inicio de Web Scraper: “Replace your scraping infrastructure”, con la prueba gratuita de 7 días de Web Scraper Cloud

Web Scraper es una extensión de Chrome que permite construir un scraper haciendo clic en la página, sin escribir código. Llega más lejos de lo que se cree: paginación, clic en un botón “ver más”, paso de una lista a cada ficha detallada.

En concreto, abres el sitio que quieres scrapear y luego la pestaña Web Scraper de las herramientas de desarrollo. Creas un “sitemap”, es decir, el camino que seguirá la herramienta: la página de lista, el enlace a cada ficha y luego los campos por capturar en la ficha (nombre, dirección, teléfono). Lanzas la extracción, el navegador recorre las páginas ante tus ojos y obtienes un archivo CSV o Excel. Los tutoriales son fáciles de seguir, incluso sin haber escrito una línea de código en tu vida.

La extensión funciona en tu computadora: durante un scraping grande, el navegador queda ocupado. Web Scraper Cloud ejecuta los mismos sitemaps en los servidores del proveedor, con programación y API. El proveedor precisa que su versión Cloud no extrae datos de las redes sociales, LinkedIn incluido.

La extensión es gratuita para uso local. Web Scraper Cloud empieza con el plan Project a US$ 50 al mes (US$ 40 en anual), luego Professional a US$ 100 y Scale desde US$ 200, con una prueba de 7 días.

04

Apify

4.0/5 Desde US$ 19

Ideal para: Scrapear entre 1000 y 10 000 filas con bots preconfigurados, sin gestionar un servidor

+ Fortalezas
  • Biblioteca muy completa de “actores”, bots preconfigurados
  • Ninguna configuración de servidor que gestionar, rotación de IP incluida
  • Bots integrados en flujo vía API para actualizar los datasets
  • Plan gratuito
− Debilidades
  • Requiere una cultura web bastante buena
  • Puede costar caro rápido en un proyecto que llama mucho a un mismo sitio
★ Apify en resumen

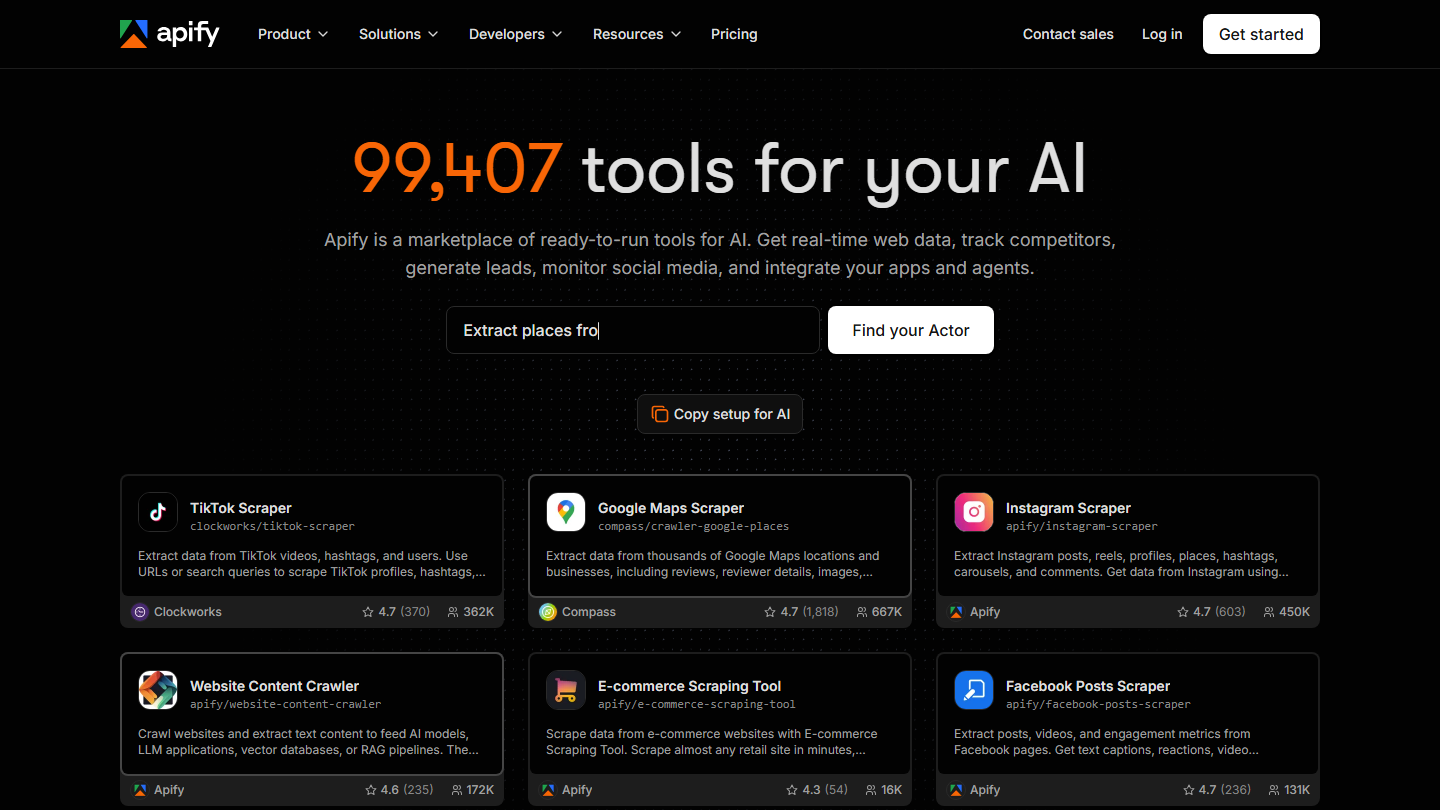
Página de inicio de Apify: la búsqueda de Actors y de scrapers listos para usar para TikTok, Google Maps o Instagram

Apify es una plataforma donde se ejecutan scrapers en la nube, sin instalar nada. Su fuerte es su biblioteca: cerca de 100 000 “Actors”, robots ya escritos para Google Maps, Instagram, TikTok, los sitios de e-commerce o cualquier sitio que se quiera recorrer.

En concreto, buscas el Actor que corresponde a tu necesidad, por ejemplo “Google Maps Scraper”, llenas un formulario (palabras clave, ciudad, número de resultados) y lo lanzas. Los resultados llegan en una tabla exportable en CSV, Excel o JSON. La plataforma gestiona los servidores y la rotación de direcciones IP, lo que evita que el sitio objetivo te bloquee.

Usamos Apify para construir el email finder de Salesdorado: en nuestros usos, los Actors corrían unas diez veces más rápido que las mismas tareas en PhantomBuster. Los Actors también se pueden lanzar por API, para actualizar un conjunto de datos a intervalos regulares. Una parte de los Actors la publican desarrolladores independientes: mira la calificación y el número de usuarios antes de fiarte.

El plan gratuito da US$ 5 de créditos de uso al mes, suficiente para probar. El plan Starter cuesta US$ 19 al mes, luego Scale a US$ 199 y Business a US$ 999.

05

Scrapy

4.3/5 Desde Gratis

Ideal para: Los desarrolladores de Python que quieren scrapear rápido, en local, en sus servidores o en la nube

+ Fortalezas
  • Una referencia para los aficionados a Python
  • Framework muy eficiente y bien documentado
  • Se ejecuta en local, en servidores o lambdas, o en Scrapy Cloud
  • Gratuito y de código abierto
− Debilidades
  • Limitado en las páginas generadas en JavaScript
  • Reservado a quienes escriben Python
★ Scrapy en resumen

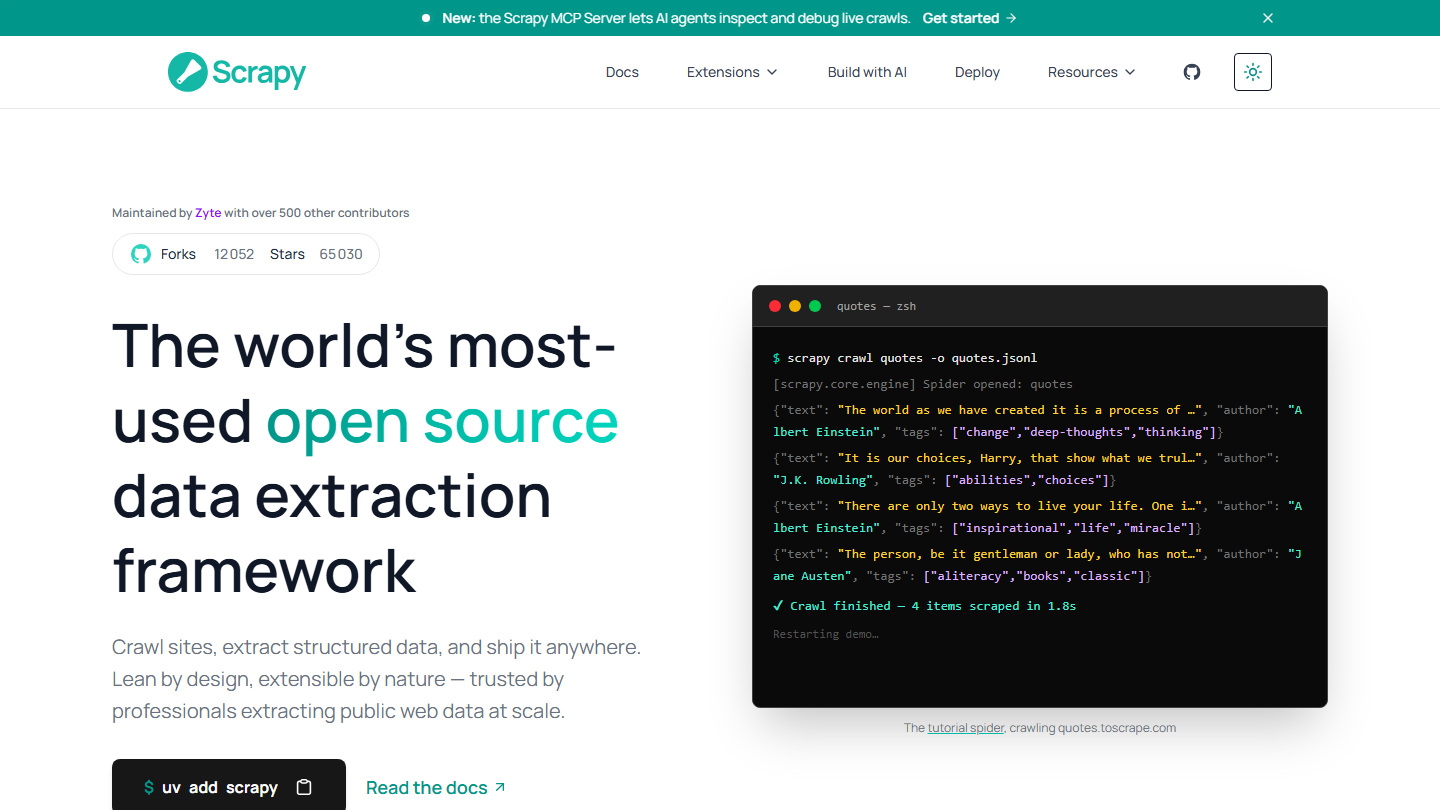
Página de inicio de Scrapy: “The world’s most-used open source data extraction framework”, con un ejemplo de crawl en línea de comandos

Scrapy es el framework de referencia para scrapear en Python. Es gratuito, de código abierto y lo mantiene la empresa Zyte con más de 500 colaboradores.

En concreto, escribes una “spider”, una clase de Python que dice dónde empezar, qué enlaces seguir y qué campos capturar en cada página. Scrapy se encarga del resto: solicitudes en paralelo, cola de espera, reintentos en caso de error, exportación a CSV o JSON. Lo ejecutas en local, en tus servidores o tus lambdas, o en Scrapy Cloud, el alojamiento que ofrece Zyte.

Su límite está en las páginas construidas en JavaScript, cada vez más frecuentes: Scrapy lee el código HTML que devuelve el servidor, no la página tal como la muestra el navegador. A menudo, la página va a buscar sus datos a una API a la que se puede llamar directamente, y Scrapy vuelve a ser la buena solución.

Scrapy es gratuito. Scrapy Cloud tiene un plan Starter gratuito (una hora de crawl, datos conservados 7 días) y un plan Pro a US$ 9 al mes por unidad.

06

Puppeteer

4.4/5 Desde Gratis

Ideal para: Los proyectos grandes sobre páginas generadas en JavaScript, cuando la fuente de datos sigue siendo inaccesible

+ Fortalezas
  • Pasa por casi todos los sitios, páginas JavaScript incluidas
  • Simple de escribir en NodeJS y notablemente bien documentado
  • Biblioteca gratuita y de código abierto, mantenida por Google, que controla Chrome o Firefox
− Debilidades
  • Requiere conocimientos previos
  • Costoso de implementar, en tiempo o en dinero
★ Puppeteer en resumen

Página de inicio de la documentación de Puppeteer, biblioteca de JavaScript que controla Chrome o Firefox

Puppeteer es una biblioteca de JavaScript que controla un navegador de verdad, Chrome o Firefox, desde un script. El navegador carga la página como lo haría un visitante, JavaScript incluido, y luego el script lee lo que se muestra. Es la solución de último recurso cuando no se puede llamar directamente a la fuente de datos (casi siempre devuelve un error 403).

En concreto, un script de Puppeteer abre una página, espera a que aparezca un elemento, hace clic, se desplaza, llena un campo de búsqueda y luego obtiene el texto deseado. En Salesdorado lo usamos en NodeJS: es simple de escribir y está notablemente bien documentado. Los aficionados a Python irán más bien a Selenium; Playwright, de un equipo de Microsoft, propone el mismo enfoque en varios lenguajes.

Un navegador consume mucha más memoria y tiempo que una simple solicitud: cada página cuesta más de scrapear que con Scrapy. Antes de escribir tu script, verifica que no exista ya un robot para ese sitio en Apify. Funciona bastante seguido y te evita problemas.

Puppeteer es gratuito y de código abierto, mantenido por el equipo de automatización del navegador Chrome en Google.

¿Cómo elegimos estas 6 herramientas?

Cada herramienta de esta selección se ha usado en condiciones reales por nuestro equipo o por un consultor de Salesdorado, en un contexto de sales y marketing B2B. Ningún ranking hecho a partir de un dossier de marketing. El orden de la lista no es una clasificación: la herramienta adecuada depende de su necesidad.

  1. 01
    Alcance del benchmark

    Identificación amplia de las herramientas del mercado (G2, Capterra, comentarios de clientes de Salesdorado, señales de LinkedIn). Filtrado inicial y luego short-list a partir de un setup de 2 h por herramienta.

  2. 02
    Condiciones de prueba

    3 a 4 semanas de uso activo por herramienta, con datos representativos de un use-case de sales B2B. Cuando la herramienta apunta a un perfil concreto (SDR, AE, Ops, Marketer…), alineamos al tester en consecuencia.

  3. 03
    Criterios ponderados

    Para cada categoría, de 5 a 7 ejes ponderados según lo que está en juego en el segmento: UX, profundidad funcional, integraciones nativas, soporte, pricing a escala, cumplimiento (RGPD, seguridad) y calidad de la roadmap.

  4. 04
    Independencia

    Ninguna herramienta se puntúa a cambio de una retribución. Los enlaces de partners (afiliación) se marcan como tales y no influyen en la nota. Las herramientas que no son partners se incluyen si su lugar en el ranking está justificado.

  5. 05
    Actualización

    La clasificación se revisa cada 6 a 12 meses o en cada release importante de una herramienta citada. La fecha de la última verificación se muestra al principio del artículo.

Las preguntas que nos hacen una y otra vez.

¿Se puede hacer web scraping sin una herramienta?

Sí, con un simple copiar y pegar. Puedes copiar todas las tablas de Wikipedia en un archivo de Excel o en una hoja de cálculo de Google: códigos postales, nombres comunes o prefijos telefónicos se obtienen en un minuto. El método es muy rápido pero muy limitado.

¿Cómo scrapear una página web con Google Sheets?

Con la función =importxml y una consulta XPath. Por ejemplo, =importxml(“https://salesdorado.com/automatisation/meilleurs-outils-webscraping/”, “//h2”) obtiene todos los títulos H2 de la página. El método se vuelve difícilmente viable más allá de 1000 filas.

¿Qué herramienta de scraping elegir sin saber programar?

Web Scraper es una herramienta no-code, bastante sencilla de usar, que gestiona la paginación y las interacciones con la página, sin XPath que escribir. Eso sí, es bastante lenta, tanto para configurarla como para ejecutarla.

¿Cómo scrapear páginas generadas en JavaScript?

Busca primero la fuente de datos directamente en la pestaña “Network” del navegador. Si no se puede llamar, queda pasar por un navegador: Puppeteer en NodeJS, o Selenium para quienes prefieren Python.

¿Conviene ejecutar el scraping en local o en la nube?

Si llamas a muchos sitios, pocas veces a cada uno, ejecuta todo en local con una buena velocidad de Internet. Si llamas a un solo sitio muchas veces, mira AWS Lambda para gestionar la rotación de IP.

★ La conversación, 0 comentarios

Lo que dice la comunidad.

Markdown básico, moderación en 24 h
Cargando…

    En la misma categoría