


- Um registro duplicado aparece várias vezes em uma mesma base; um dado duplicado aparece em várias bases ou arquivos do sistema de informação.
- Cadastros sem verificação, ferramentas de importação, integrações que não consultam o CRM, bugs: as duplicatas têm várias origens.
- 2% de dados duplicados não é um drama. Acima de 5%, as coisas se complicam.
- Normalizar os dados, calcular scores de similaridade (Levenshtein, Soundex…), combiná-los em um score global e depois fundir.
- Em SQL, preveja regras de unmerging: fundir dois contatos que não são idênticos é um dos maiores riscos.
O desempenho das suas ações de marketing & CRM depende em boa parte da qualidade das suas bases de dados de clientes. Você precisa limpá-las regularmente. O que, entre outras coisas, passa por deduplicar e remover contatos duplicados. O que é isso? Por que é importante? Como funciona? Quais ferramentas usar? É o que veremos neste artigo. No final, como bônus, apresentamos um pequeno tutorial para deduplicar seus contatos em SQL.
Por que a deduplicação é tão importante?
A deduplicação consiste em identificar os dados que aparecem em vários arquivos do sistema de informação e mantê-los em um único arquivo por meio de uma fusão (ou merging, em inglês). Na gestão de bases de dados, na maioria das vezes trata-se de deduplicar contatos.
Um sistema de informação do tipo CRM, por exemplo, tende necessariamente a gerar contatos duplicados em vários lugares diferentes do sistema.
As causas da duplicação de dados
Por pelo menos 4 motivos:
- As pessoas que gerenciam o CRM às vezes adicionam contatos ou criam contas sem verificar se eles já foram registrados no sistema. Mesmo que o seu CRM envie notificações em caso de duplicação, nem todo mundo presta atenção nelas, e as notificações nem sempre aparecem bem no celular.
- As ferramentas de importação de dados nem sempre identificam bem as duplicações.
- As integrações com fontes externas de dados, como formulários do site, portais de parceiros ou brokers de e-mails, nem sempre consultam os dados do CRM antes de importar os novos dados.
- Muitos erros humanos ou bugs de software (bugs do CRM ou dos aplicativos / ferramentas associados) podem gerar facilmente centenas ou milhares de duplicações.
O impacto dos dados duplicados
Ter 2% de dados duplicados não é um drama, desde que sejam dados de vida curta e que suas ferramentas e processos permitam detectá-los e corrigi-los. Acima de 5% de duplicações, as coisas se complicam.
É a partir desse limite que os usuários começam a reclamar e que os relatórios levam a análises erradas.
Detectar e corrigir dados duplicados é um trabalho que leva tempo e exige muito rigor metodológico.
Você precisa escolher as ferramentas certas de detecção de dados duplicados, usá-las bem, identificar a partir delas os principais motivos pelos quais o seu sistema de informação gera dados duplicados e, com base nesse entendimento, estancar as principais fontes de duplicações.
As vantagens da deduplicação de dados
Ter um sistema de informação com o mínimo possível de dados duplicados permite:
- Ter uma base de dados mais limpa: a deduplicação é uma etapa-chave da limpeza de bases de dados.
- Reduzir os custos de manutenção e armazenamento do seu sistema.
- Reduzir os custos de envio das suas campanhas e, de forma mais ampla, todos os custos de marketing.
- Melhorar a experiência do cliente > Não há nada mais irritante para um cliente do que ser impactado várias vezes por uma mesma ação, campanha ou cenário de marketing. A deduplicação evita o desgaste da imagem da marca causado pelo envio de mensagens duplicadas.
- Conhecer melhor os seus clientes, limitando a dispersão dos dados em várias tabelas.
- Melhorar a confiabilidade dos relatórios e das decisões tomadas com base neles.
O aumento do número de fontes de dados e de pontos de contato tende a favorecer a criação de dados duplicados. Quando você usa dezenas de ferramentas, bases e canais, o risco de um cliente estar registrado em vários lugares do sistema não é desprezível. Daí a importância de encarar o assunto!
Deduplicação vs. remoção de duplicatas
É comum confundir deduplicação com remoção de duplicatas. No entanto, são duas coisas bem diferentes.
Falamos de « registro duplicado » quando uma informação, um dado, está presente várias vezes em uma mesma base de dados ou em um mesmo arquivo.
Falamos de « dado duplicado » quando um mesmo dado está presente em várias bases ou arquivos do sistema de informação. O problema dos dados duplicados é especialmente relevante na prospecção. Quando você usa vários arquivos de prospecção diferentes, é fácil um contato estar presente em vários deles. Nesse caso, a deduplicação de dados evita que você entre em contato várias vezes com o mesmo prospect.
Ainda assim, essa distinção não deve ser levada ao pé da letra. O ponto em comum entre a duplicação e o registro duplicado é que ambos resultam na presença de dois contatos/dados idênticos no sistema de informação. Em um sistema de informação unificado com visão única do cliente, as operações de remoção de duplicatas e de deduplicação são bem parecidas.
Quais são as abordagens clássicas de deduplicação?
A criação de dados duplicados costuma estar ligada a diferenças sintáticas resultantes de erros de digitação, inversões, uso de abreviações ou ainda da evolução natural dos dados ao longo do tempo (mudança de endereço, mudança de nome etc.). Para lidar com esses problemas de forma eficaz em grande escala, é indispensável implementar mecanismos de automação.
Veja as principais etapas de um processo clássico de deduplicação:
1. Normalização e validação dos dados
A primeira etapa consiste em reestruturar e normalizar os dados para facilitar a comparação. Isso inclui, por exemplo:
- O tratamento RNVP (Reestruturação, Normalização, Validação Postal) dos endereços
- A normalização dos números de telefone
- A conversão das strings para maiúsculas ou minúsculas
- A remoção de acentos e caracteres especiais
O objetivo, como você já entendeu, é harmonizar ao máximo o formato dos dados para limitar as variações sintáticas.
2. Cálculo dos scores de similaridade
A segunda etapa avalia o grau de similaridade entre os registros, para cada tipo de dado (sobrenome, nome, endereço, e-mail, telefone…).
Duas abordagens são possíveis:
- A análise de similaridade de strings, usando algoritmos de cálculo de distância como Levenshtein ou Hamming. Esses algoritmos medem o número de alterações necessárias para passar de uma string a outra.
- A análise de similaridade fonética, que consiste em comparar os dados pelo som, e não pelo texto. Algoritmos como Soundex, Metaphone ou Double Metaphone são muito usados nesse caso.
Esses scores de similaridade permitem identificar os registros que, apesar das diferenças sintáticas, têm grande probabilidade de se referir a uma mesma entidade.
3. Cálculo de um score de similaridade global
A última etapa consiste em combinar os diferentes scores de similaridade (sobrenome, nome, endereço…) para obter um score global para cada par de registros. Esse score reflete a probabilidade de dois registros serem duplicados.
Modelos de machine learning, como as florestas aleatórias (random forests), costumam ser usados nessa etapa para analisar os scores de similaridade e decidir o limite a partir do qual dois registros devem ser considerados duplicados.
Depois de identificados os duplicados, a próxima etapa é a fusão dos registros (ou merging). Ela exige a definição de regras para determinar, em caso de conflito, qual fonte de dados deve ter prioridade.
Qual ferramenta usar para deduplicar os seus dados de clientes?
Vamos agora apresentar 2 ótimas ferramentas para deduplicar os seus dados de clientes.
DQE Software
Criada em 2008, a DQE Software é uma fornecedora de soluções especializadas na gestão de Data Quality e na implantação de repositórios únicos de clientes. A DQE desenvolveu várias tecnologias inteligentes de otimização da qualidade dos dados de clientes, cobrindo toda a cadeia, da coleta dos dados à ativação no marketing.
As soluções da DQE estão disponíveis na nuvem (SaaS) ou em versões hospedadas nos servidores da empresa. Elas foram pensadas para se integrar facilmente às ferramentas de CRM e ERP. Com mais de 150.000 usuários e um crescimento anual de +20%, a DQE Software é uma referência no mercado.
Leia tambémConheça o nosso top de softwares de CRM & marketing B2B com versão gratuita.
Amabis
Presente na França e no Marrocos, a Amabis é uma empresa francesa que atua há mais de 20 anos no mercado de gestão de dados de clientes. A empresa tem cerca de 500 clientes.
Historicamente, a Amabis era especializada na gestão terceirizada de bases de CRM & marketing (AmaBase), o que lhe permitiu adquirir uma sólida expertise na gestão de dados de clientes e se tornar um player de primeiro plano no universo do Data Quality Management. Desde 2015, a Amabis oferece um novo CRM, o AmaCRM, que integra nativamente a gestão de Data Quality.
Qual fornecedor escolher para ajudar na deduplicação dos dados?
A deduplicação dos dados de clientes é um desafio estratégico para as empresas, mas também é um projeto complexo que exige competências bem específicas, tanto técnicas quanto de negócio.
Muitas vezes vale a pena contar com um fornecedor externo para conduzir esse tipo de projeto.
Veja alguns critérios a considerar para escolher um bom fornecedor:
- A experiência e as referências. Prefira um fornecedor que já tenha conduzido muitos projetos de deduplicação, de preferência no seu setor. Isso é o básico. Não hesite em pedir referências e cases de clientes parecidos com a sua empresa/projeto.
- A metodologia e as ferramentas. O fornecedor precisa ser capaz de explicar com clareza a metodologia e as ferramentas que usa. Então verifique se a abordagem dele é estruturada, industrializável e adequada aos seus volumes de dados.
- O acompanhamento e a transferência de competências. Além do serviço técnico, é muito importante que o fornecedor acompanhe você na adoção da solução e na transferência de competências para as suas equipes. Um bom parceiro deve tornar você autônomo. Essa é a finalidade.
- O conhecimento do seu ecossistema de ferramentas. O ideal é que o fornecedor conheça bem as ferramentas que você usa (CRM, ferramentas de automação de marketing, soluções de dados etc.).
- A capacidade de tratar os temas relacionados. Um projeto de deduplicação costuma fazer parte de uma iniciativa mais ampla de qualidade de dados. Aliás, não existem fornecedores focados apenas em deduplicação. Os fornecedores que você vai buscar são fornecedores de dados, capazes de tratar toda uma série de problemas de dados, dos quais a deduplicação é apenas um componente.
E se você aprendesse a deduplicar sozinho em SQL?
Você sabia que é possível deduplicar os dados de clientes da sua base de dados relacional com uma « simples » consulta SQL? Fizemos algumas capturas de tela para explicar rapidamente a lógica. A consulta que vamos apresentar permite transformar uma tabela de contatos em uma visão única do cliente. Este é o resultado:
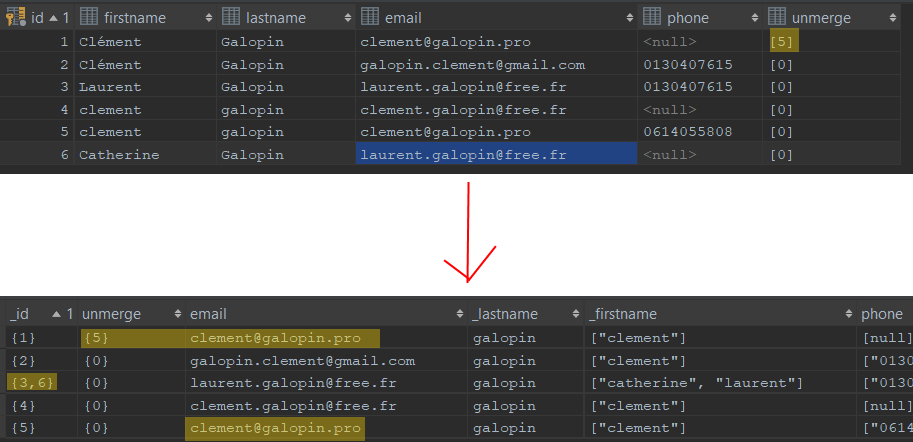
A primeira captura mostra a tabela antes da execução da consulta SQL, a segunda mostra a tabela depois da execução.
Como você pode ver, essa consulta leva em conta regras de unmerging, para que dois contatos associados por engano possam ser separados depois. É muito prático. Neste caso, isso evita que dois membros da mesma família sejam associados por terem o mesmo sobrenome.
Lembrando que a deduplicação é o processo de fundir os contatos idênticos que estão nas suas bases. Nesse processo, um dos maiores riscos é fundir contatos que não são idênticos. As regras de unmerging funcionam como proteção.
Se você decidir deduplicar seus contatos em SQL, recomendamos fortemente implementar essas regras.
Leia tambémConheça o nosso guia completo sobre a arte de identificar os visitantes anônimos de um site em B2B.
A outra vantagem dessa consulta SQL é que ela consegue fazer um fuzzy join no nome, tratando como iguais os nomes com / sem acento e os nomes com / sem maiúscula > Clément = clement. Lembrando que as diferenças ortográficas / sintáticas são a principal fonte de duplicatas.
Esta é a consulta:
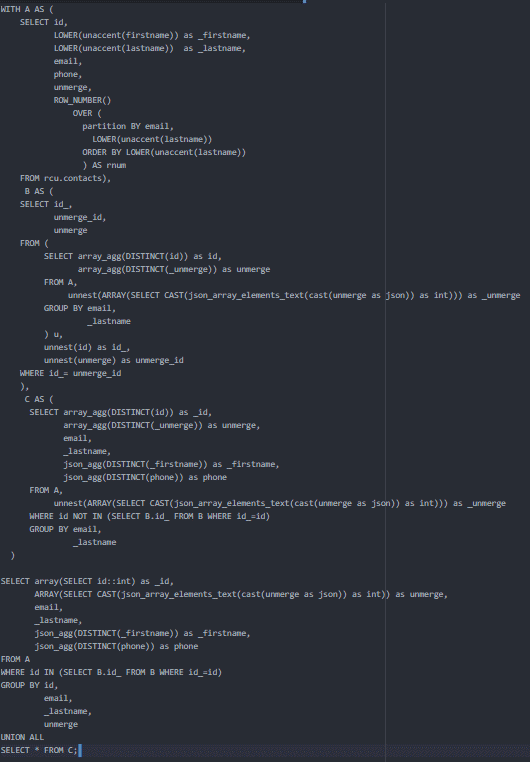
Dedicamos um tempo para detalhar cada uma das partes que ela contém, para ajudar você a entender melhor a lógica.
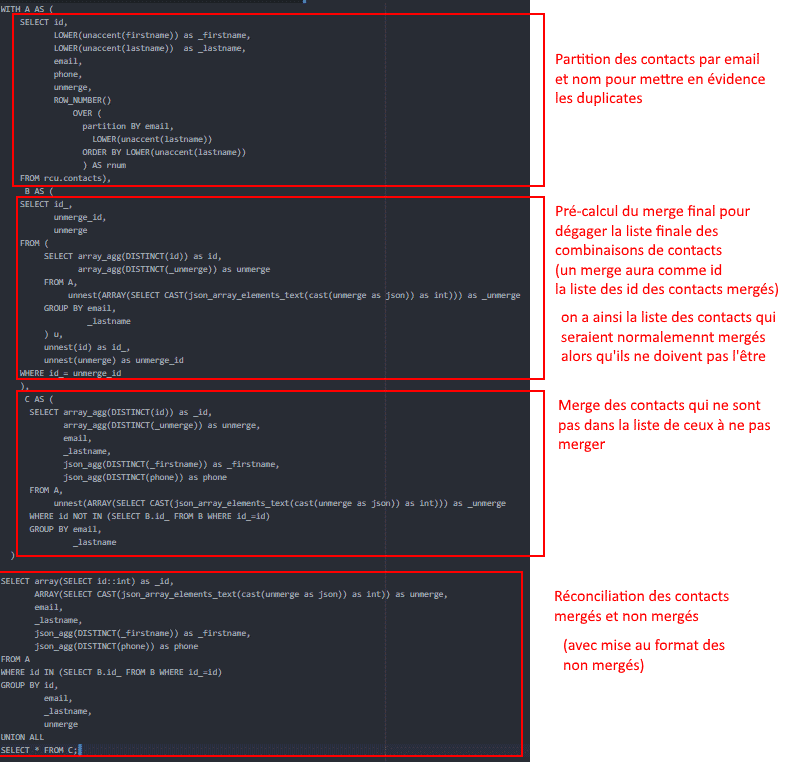
Se você domina a linguagem SQL e a gestão de bases de dados relacionais, pode fazer a deduplicação dos seus dados de clientes em SQL. Era isso que queríamos mostrar com este pequeno exemplo.
As perguntas que nos fazem sem parar.
Qual é a diferença entre deduplicação e remoção de duplicatas?
Fala-se de registro duplicado quando um dado está presente várias vezes em uma mesma base de dados ou em um mesmo arquivo, e de dado duplicado quando um mesmo dado está presente em várias bases ou arquivos do sistema de informação. Em um sistema de informação unificado com visão única do cliente, as duas operações são bem parecidas.
Por que um CRM gera dados duplicados?
As pessoas que gerenciam o CRM adicionam contatos sem verificar se eles já existem, as ferramentas de importação identificam mal as duplicações, as integrações com fontes externas (formulários, portais de parceiros, brokers de e-mails) nem sempre consultam o CRM antes de importar, e erros humanos ou bugs podem criar milhares de duplicações.
A partir de qual taxa de dados duplicados é preciso agir?
Ter 2% de dados duplicados não é um drama, desde que sejam dados de vida curta que suas ferramentas e processos permitam detectar e corrigir. Acima de 5%, os usuários começam a reclamar e os relatórios levam a análises erradas.
Quais são as etapas de um processo clássico de deduplicação?
Normalizar e validar os dados (RNVP dos endereços, números de telefone, maiúsculas e minúsculas, acentos), calcular scores de similaridade por tipo de dado, combiná-los em um score global para cada par de registros e depois fundir as duplicatas segundo regras que dizem qual fonte tem prioridade.
É possível deduplicar contatos em SQL?
Sim, uma consulta SQL em uma base de dados relacional pode transformar uma tabela de contatos em uma visão única do cliente. É altamente recomendável prever regras de unmerging, que funcionam como proteção contra a fusão de contatos que não são idênticos.



O que a comunidade diz.