


- Un registro duplicado aparece varias veces en una misma base; un dato duplicado aparece en varias bases o archivos del sistema de información.
- Capturas sin verificación, herramientas de importación, integraciones que no consultan el CRM, bugs: los duplicados tienen varios orígenes.
- Un 2 % de datos duplicados no es un drama. Por encima del 5 %, las cosas se complican.
- Normalizar los datos, calcular scores de similitud (Levenshtein, Soundex…), combinarlos en un score global y luego fusionar.
- En SQL, prevé reglas de unmerging: fusionar dos contactos que no son idénticos es uno de los mayores riesgos.
El rendimiento de tus acciones de marketing & CRM depende en buena parte de la calidad de tus bases de datos de clientes. Tienes que limpiarlas con regularidad. Lo que, entre otras cosas, pasa por deduplicar y eliminar contactos duplicados. ¿Qué es? ¿Por qué es importante? ¿Cómo funciona? ¿Qué herramientas usar? Eso es lo que vemos en este artículo. Al final, como bonus, te presentamos un pequeño tutorial para deduplicar tus contactos en SQL.
¿Por qué la deduplicación es tan importante?
La deduplicación consiste en identificar los datos que aparecen en varios archivos del sistema de información y conservarlos en un solo archivo mediante una fusión (merging, en inglés). En la gestión de bases de datos, la mayoría de las veces se trata de deduplicar contactos.
Un sistema de información de tipo CRM, por ejemplo, tiende necesariamente a generar contactos duplicados en varios lugares distintos del sistema.
Las causas de la duplicación de datos
Por al menos 4 razones:
- Las personas que gestionan el CRM a veces agregan contactos o crean cuentas sin verificar si ya estaban registrados en el sistema. Aunque tu CRM envíe notificaciones en caso de duplicación, no todo el mundo les presta atención, y las notificaciones no siempre se ven bien en el celular.
- Las herramientas de importación de datos no siempre identifican bien los duplicados.
- Las integraciones con fuentes de datos externas, como los formularios del sitio web, los portales de partners o los brokers de emails, no siempre consultan los datos del CRM antes de importar los nuevos datos.
- Muchos errores humanos o bugs de software (bugs del CRM o de las aplicaciones / herramientas asociadas) pueden generar fácilmente cientos o miles de duplicados.
El impacto de los datos duplicados
Tener un 2 % de datos duplicados no es un drama, siempre que se trate de datos de corta vida y que tus herramientas y procesos permitan detectarlos y corregirlos. Por encima del 5 % de duplicados, las cosas se complican.
A partir de ese umbral, los usuarios empiezan a quejarse y los reportes llevan a análisis erróneos.
Detectar y corregir los datos duplicados es un trabajo que lleva tiempo y que exige mucho rigor metodológico.
Tienes que elegir las herramientas adecuadas de detección de duplicados, usarlas bien, identificar con ellas las principales razones por las que tu sistema de información genera datos duplicados y, a partir de esa comprensión, cortar las principales fuentes de duplicados.
Las ventajas de la deduplicación de datos
Contar con un sistema de información con la menor cantidad posible de datos duplicados permite:
- Tener una base de datos más limpia: la deduplicación es una etapa clave de la limpieza de bases de datos.
- Reducir los costos de mantenimiento y almacenamiento de tu sistema.
- Reducir los costos de envío de tus campañas y, en general, todos los costos de marketing.
- Mejorar la experiencia del cliente > No hay nada más molesto para un cliente que verse impactado varias veces por una misma acción, campaña o escenario de marketing. La deduplicación evita el deterioro de la imagen de marca que provoca el envío de mensajes duplicados.
- Conocer mejor a tus clientes limitando la dispersión de los datos en varias tablas.
- Mejorar la confiabilidad de los reportes y de las decisiones que se toman a partir de ellos.
El aumento del número de fuentes de datos y de puntos de contacto tiende a favorecer la creación de datos duplicados. Cuando usas decenas de herramientas, bases y canales, el riesgo de que un cliente quede registrado en varios lugares del sistema no es despreciable. ¡De ahí la importancia de ocuparse del tema!
Deduplicación vs. eliminación de duplicados
Se suele confundir la deduplicación con la eliminación de duplicados. Sin embargo, son dos cosas bastante diferentes.
Hablamos de «registro duplicado» cuando una información, un dato, está presente varias veces en una misma base de datos o en un mismo archivo.
Hablamos de «dato duplicado» cuando un mismo dato está presente en varias bases o archivos del sistema de información. El problema de los datos duplicados es especialmente importante en la prospección. Cuando usas varios archivos de prospección distintos, es fácil que un contacto aparezca en varios archivos. En ese caso, la deduplicación de datos evita contactar varias veces a un mismo prospecto.
Aun así, no hay que tomar esta distinción como absoluta. Lo que tienen en común la duplicación y el registro duplicado es que ambos generan la presencia de dos contactos/datos idénticos en el sistema de información. En un sistema de información unificado con una vista única del cliente, las operaciones de eliminación de duplicados y de deduplicación son bastante parecidas.
¿Cuáles son los enfoques clásicos de deduplicación?
La creación de datos duplicados suele deberse a diferencias sintácticas que resultan de errores de captura, inversiones, el uso de abreviaturas, o incluso de la evolución natural de los datos en el tiempo (mudanza, cambio de apellido, etc.). Para gestionar estos problemas de forma eficaz a gran escala, es indispensable implementar mecanismos de automatización.
Estas son las principales etapas de un proceso clásico de deduplicación:
1. Normalización y validación de los datos
La primera etapa consiste en reestructurar y normalizar los datos para facilitar su comparación. Esto incluye, por ejemplo:
- El procesamiento RNVP (Reestructuración, Normalización, Validación Postal) de las direcciones
- La normalización de los números de teléfono
- El paso a mayúsculas o minúsculas de las cadenas de caracteres
- La eliminación de acentos y caracteres especiales
El objetivo, como ya habrás entendido, es armonizar al máximo el formato de los datos para limitar las variaciones sintácticas.
2. Cálculo de los scores de similitud
La segunda etapa busca evaluar el grado de similitud entre los registros, para cada tipo de dato (apellido, nombre, dirección, email, teléfono…).
Hay dos enfoques posibles:
- El análisis de similitud de cadenas de caracteres, con algoritmos de cálculo de distancia como Levenshtein o Hamming. Estos algoritmos miden el número de modificaciones necesarias para pasar de una cadena a otra.
- El análisis de similitud fonética, que consiste en comparar los datos desde el punto de vista del sonido y no del texto. En este caso se usan con frecuencia algoritmos como Soundex, Metaphone o Double Metaphone.
Estos scores de similitud permiten identificar los registros que, a pesar de sus diferencias sintácticas, tienen una alta probabilidad de referirse a una misma entidad.
3. Cálculo de un score de similitud global
La última etapa consiste en combinar los distintos scores de similitud (apellido, nombre, dirección…) para obtener un score global para cada par de registros. Este score refleja la probabilidad de que dos registros sean duplicados.
En esta etapa se suelen usar modelos de machine learning, como los bosques aleatorios (random forests), para analizar los scores de similitud y decidir el umbral a partir del cual dos registros deben considerarse duplicados.
Una vez identificados los duplicados, la siguiente etapa es la fusión de los registros (o merging). Supone definir reglas para determinar, en caso de conflicto, qué fuente de datos debe tener prioridad.
¿Qué herramienta usar para deduplicar tus datos de clientes?
Ahora te vamos a presentar 2 muy buenas herramientas para deduplicar tus datos de clientes.
DQE Software
Creada en 2008, DQE Software es un editor de soluciones especializadas en la gestión de la Data Quality y la implementación de repositorios únicos de clientes. DQE desarrolló varias tecnologías inteligentes de optimización de la calidad de los datos de clientes, que cubren toda la cadena, desde la recolección de los datos hasta su activación en marketing.
Las soluciones de DQE están disponibles en la nube (SaaS) o en versiones alojadas en los servidores de la empresa. Están pensadas para integrarse fácilmente con las herramientas CRM y ERP. Con más de 150 000 usuarios y un crecimiento anual de +20%, DQE Software es una referencia en el mercado.
Lee tambiénDescubre nuestro top de software CRM & marketing B2B con versión gratuita.
Amabis
Con presencia en Francia y Marruecos, Amabis es una empresa francesa que lleva más de 20 años en el mercado de la gestión de datos de clientes. Cuenta con cerca de 500 clientes.
Históricamente, Amabis se especializaba en la administración externalizada de bases CRM & marketing (AmaBase), lo que le permitió adquirir una sólida experiencia en la gestión de datos de clientes y convertirse en un actor de primer nivel en el universo del Data Quality Management. Desde 2015, Amabis ofrece un nuevo CRM, AmaCRM, que integra de forma nativa la gestión de la Data Quality.
¿Qué proveedor elegir para que te acompañe en la deduplicación de datos?
La deduplicación de los datos de clientes es un reto estratégico para las empresas, pero también es un proyecto complejo que requiere competencias muy específicas, tanto técnicas como de negocio.
A menudo conviene apoyarse en un proveedor externo para llevar a cabo este tipo de proyecto.
Estos son algunos criterios a tener en cuenta para elegir un buen proveedor:
- La experiencia y las referencias. Prioriza un proveedor que ya haya llevado a cabo muchos proyectos de deduplicación, idealmente en tu sector. Es lo básico. No dudes en pedir referencias y casos de clientes similares a tu empresa/proyecto.
- La metodología y las herramientas. El proveedor tiene que poder explicarte con claridad su metodología y las herramientas que usa. Así que verifica que su enfoque sea estructurado, industrializable y adaptado a tus volúmenes de datos.
- El acompañamiento y la transferencia de competencias. Más allá del servicio técnico, es realmente importante que el proveedor te acompañe en la adopción de la solución y en la transferencia de competencias a tus equipos. Un buen partner tiene que volverte autónomo. Ese es el objetivo final.
- El conocimiento de tu ecosistema de herramientas. Idealmente, el proveedor debe conocer bien las herramientas que usas (CRM, herramientas de marketing automation, soluciones de datos, etc.).
- La capacidad de abordar los temas relacionados. Un proyecto de deduplicación suele formar parte de un enfoque más global de calidad de datos. De hecho, no existen proveedores enfocados únicamente en la deduplicación. Los proveedores a los que vas a apuntar son proveedores de datos, que pueden abordar toda una serie de problemas de datos de los que la deduplicación es solo un componente.
¿Y si aprendieras a deduplicar tú mismo en SQL?
¿Sabías que es posible deduplicar los datos de clientes de tu base de datos relacional con una «simple» consulta SQL? Hicimos algunas capturas de pantalla para explicarte rápidamente la lógica. La consulta que te vamos a presentar permite transformar una tabla de contactos en una vista única del cliente. Este es el resultado:
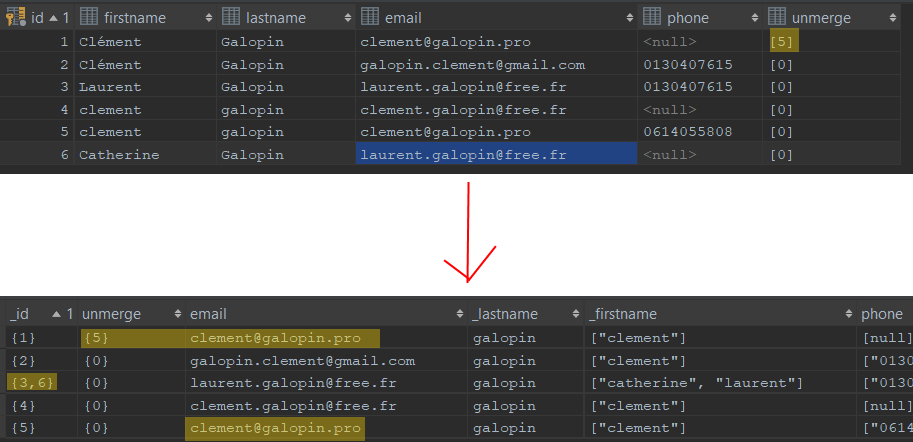
La primera captura muestra la tabla antes de ejecutar la consulta SQL, la segunda la tabla después de ejecutarla.
Como puedes ver, esta consulta tiene en cuenta reglas de unmerging, para que dos contactos asociados por error puedan separarse después. Es muy práctico. En este caso, evita que dos miembros de una misma familia queden asociados por tener el mismo apellido.
Recordemos que la deduplicación es el proceso que consiste en fusionar los contactos idénticos que hay en tus bases. En este proceso, uno de los mayores riesgos es fusionar contactos que no son idénticos. Las reglas de unmerging funcionan como salvaguardas.
Si decides deduplicar tus contactos en SQL, te recomendamos encarecidamente implementar estas reglas.
Lee tambiénDescubre nuestra guía completa sobre el arte de identificar a los visitantes anónimos de un sitio web en B2B.
La otra ventaja de esta consulta SQL es que logra hacer un fuzzy join sobre el nombre, asimilando los nombres con / sin acento y los nombres con / sin mayúscula > Clément = clement. Recordemos que las diferencias ortográficas / sintácticas son la principal fuente de duplicados.
Esta es la consulta:
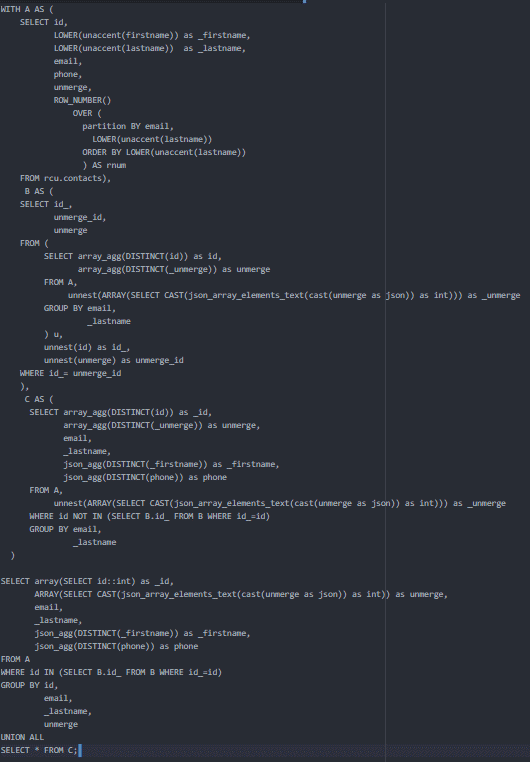
Nos tomamos el tiempo de detallar cada una de sus partes para ayudarte a entender mejor la lógica.
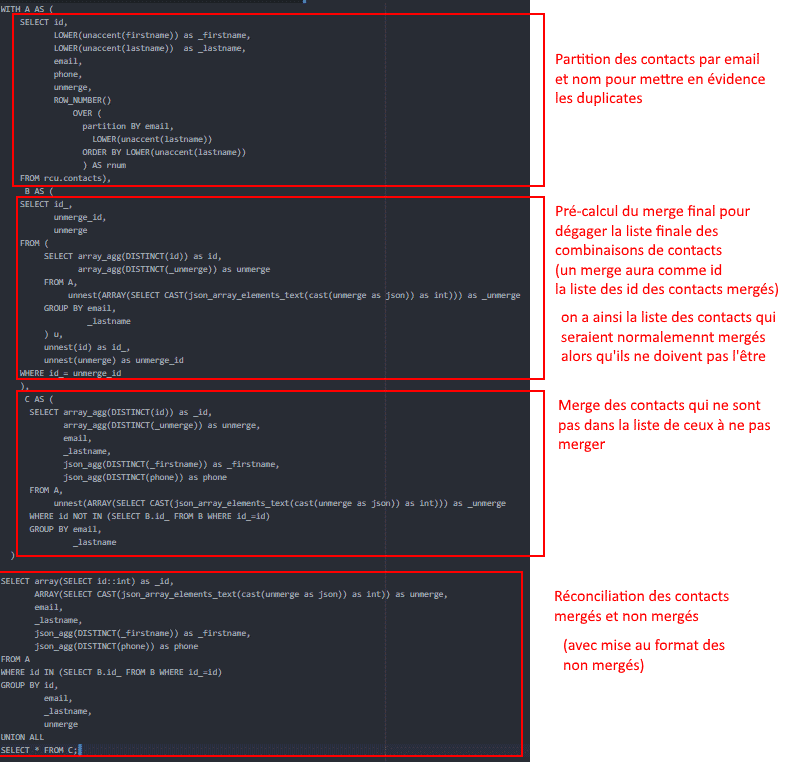
Si dominas el lenguaje SQL y la gestión de bases de datos relacionales, puedes deduplicar tus datos de clientes en SQL. Eso es lo que queríamos mostrarte con este pequeño ejemplo.
Las preguntas que nos hacen una y otra vez.
¿Cuál es la diferencia entre deduplicación y eliminación de duplicados?
Se habla de registro duplicado cuando un dato está presente varias veces en una misma base de datos o en un mismo archivo, y de dato duplicado cuando un mismo dato está presente en varias bases o archivos del sistema de información. En un sistema de información unificado con vista única del cliente, las dos operaciones son bastante parecidas.
¿Por qué un CRM genera datos duplicados?
Las personas que gestionan el CRM agregan contactos sin verificar si ya existen, las herramientas de importación identifican mal los duplicados, las integraciones con fuentes externas (formularios, portales de partners, brokers de emails) no siempre consultan el CRM antes de importar, y los errores humanos o los bugs pueden crear miles de duplicados.
¿A partir de qué porcentaje de datos duplicados hay que actuar?
Tener un 2 % de datos duplicados no es un drama, siempre que se trate de datos de corta vida que tus herramientas y procesos permitan detectar y corregir. Por encima del 5 %, los usuarios empiezan a quejarse y los reportes llevan a análisis erróneos.
¿Cuáles son las etapas de un proceso clásico de deduplicación?
Normalizar y validar los datos (RNVP de las direcciones, números de teléfono, mayúsculas, acentos), calcular scores de similitud por tipo de dato, combinarlos en un score global para cada par de registros y luego fusionar los duplicados según reglas que indican qué fuente tiene prioridad.
¿Se pueden deduplicar los contactos en SQL?
Sí, una consulta SQL sobre una base de datos relacional puede transformar una tabla de contactos en una vista única del cliente. Se recomienda encarecidamente incluir reglas de unmerging, que sirven de salvaguarda contra la fusión de contactos que no son idénticos.



Lo que dice la comunidad.