


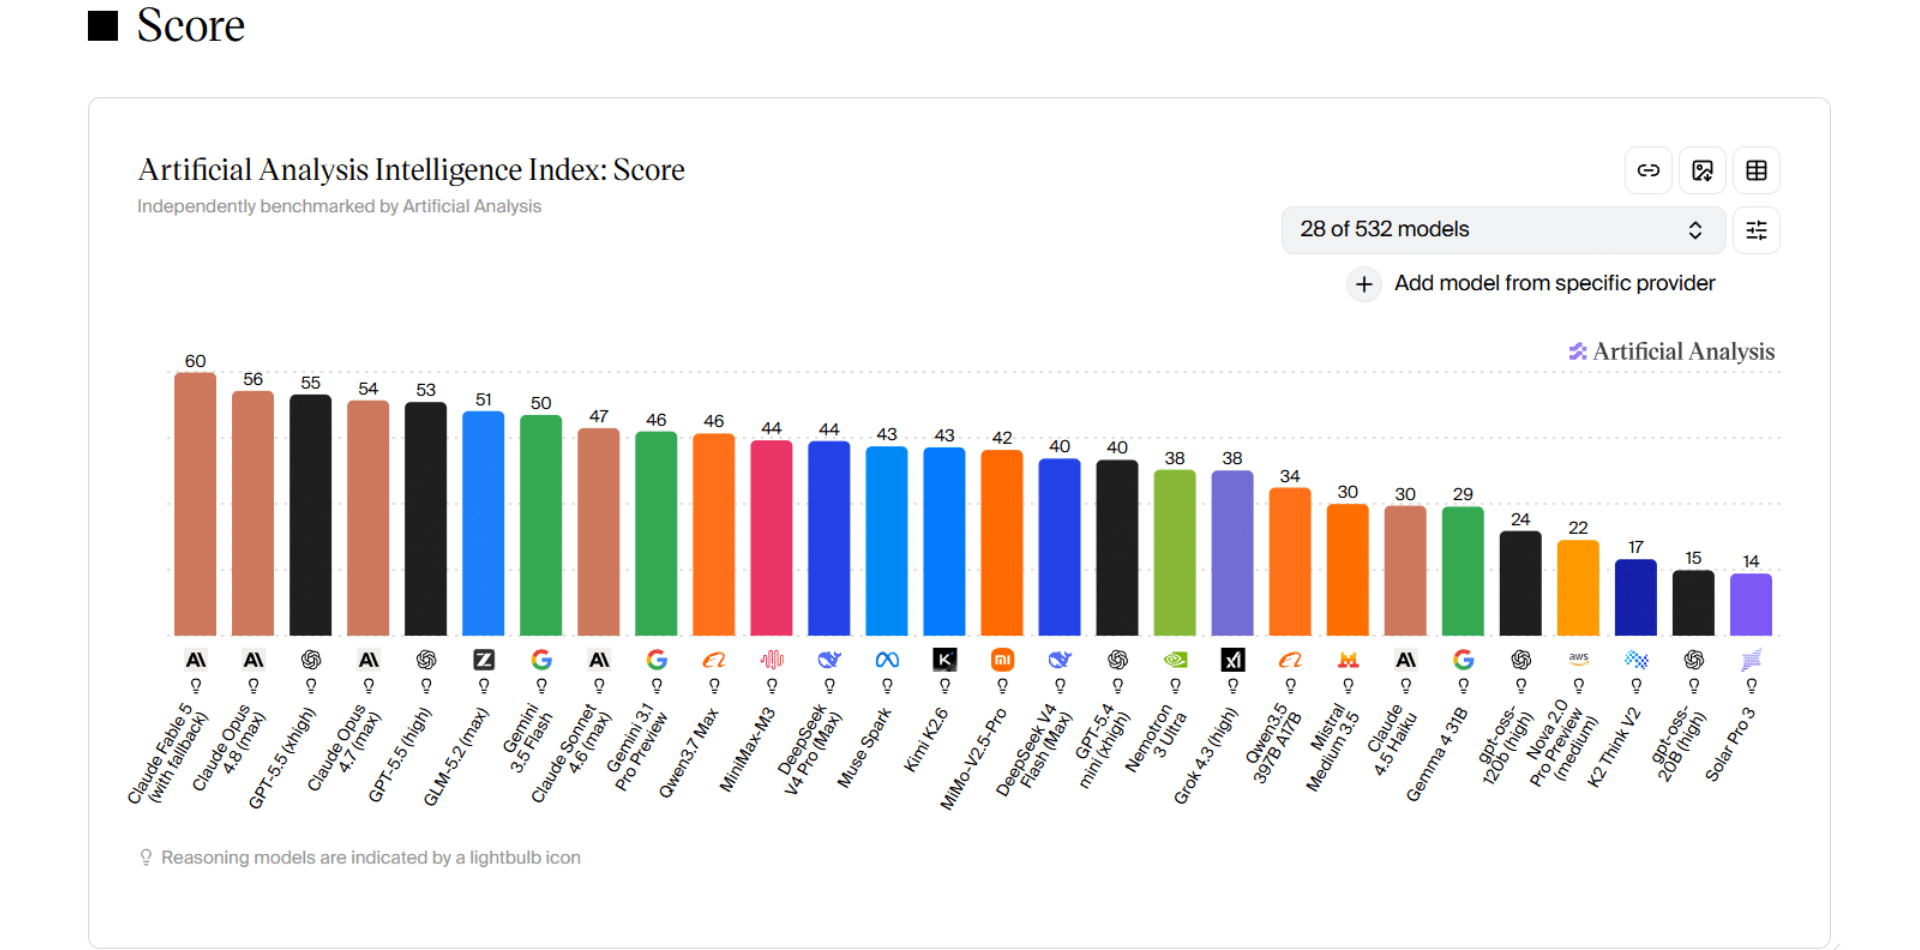
- O GLM 5.2 marca 51 pontos de 100 no Intelligence Index da Artificial Analysis, a melhor pontuação já alcançada por um modelo open weight, à frente do DeepSeek V4 Pro e do Kimi K2.6.
- Ele fica logo atrás do GPT-5.5 (55) e do Claude Opus 4.8 (56), por cerca de 1,4 dólar de entrada e 4,4 dólares de saída por milhão de tokens.
- Arquitetura mixture of experts de 744 bilhões de parâmetros, janela de contexto de um milhão de tokens, licença MIT.
- Modelo que pode ser baixado e hospedado on-premise, um argumento de soberania para as organizações francófonas.
- Sua chegada vem depois do bloqueio por Washington dos modelos Fable 5 e Mythos 5 da Anthropic.
- O outro lado: a corrida pelo consumo de tokens, o « tokenmaxxing », pode fazer os orçamentos saírem do controle.
A zAI, startup de Pequim por trás da família GLM, lançou o GLM 5.2 em meados de junho. O modelo é aberto, sob licença MIT, e fica logo atrás do GPT-5.5 e do Claude Opus 4.8 no benchmark da Artificial Analysis. Tudo isso por um preço dez vezes menor. Se você acompanha os orçamentos de IA numa equipe comercial ou de marketing francófona, vale a pena olhar de perto: um modelo desse nível, que dá para baixar e hospedar em casa, muda bastante coisa.
Um modelo aberto que encosta nos gigantes americanos
No Intelligence Index da Artificial Analysis, o GLM 5.2 marca 51 pontos de 100. Onze a mais que o GLM 5.1 e, sobretudo, o melhor resultado já alcançado por um modelo de pesos abertos. Ele passa à frente do MiniMax M3 e do DeepSeek V4 Pro (44 pontos cada), do Kimi K2.6 (43) e até do Gemini 3.5 Flash (50). Acima dele, só restam o GPT-5.5 (55) e o Claude Opus 4.8 (56). Para dar uma ideia da distância, o Fable 5 da Anthropic chegava a 60 antes de ser retirado do mercado.
A zAI também reivindica o segundo lugar mundial no benchmark front-end do Code Arena, atrás apenas do Fable 5, segundo o Yellow.com. Itamar Golan, chefe da Prompt Security, resume bem a impressão de quem testou: é o primeiro modelo aberto que não fica claramente para trás diante dos melhores sistemas proprietários.
744 bilhões de parâmetros e um contexto de um milhão de tokens
O GLM 5.2 retoma a arquitetura mixture of experts da versão anterior: 744 bilhões de parâmetros no total, mas apenas 40 bilhões ativados a cada requisição. Assim, a conta de computação fica contida, já que o modelo nunca mobiliza todo o seu peso para uma resposta.
O verdadeiro salto é a janela de contexto. Ela passa de 200.000 para um milhão de tokens. Dá para engolir de uma vez uma licitação completa, meses de histórico do CRM ou toda uma base documental. A zAI garante ter treinado o modelo com contextos longos reais, e não só ter colado um número na ficha do produto. Uma técnica própria chamada IndexShare reduz em 75 % o custo de indexação desses contextos estendidos.
O argumento que faz a diferença: o preço
É aqui que fica interessante para as diretorias que controlam os gastos. A zAI cobra 1,4 dólar por milhão de tokens de entrada e 4,4 dólares de saída. A Anthropic, por sua vez, pede 5 e 25 dólares pelo Opus. Estamos falando de uma diferença de um para cinco, e ainda maior na saída.
Wade Foster, CEO da Zapier, rodou o modelo no seu próprio benchmark, o AutomationBench. O veredito: o GLM 5.2 iguala a melhor pontuação do Opus 4.7 max, por 0,67 dólar por tarefa contra 1,80 dólar. Menos da metade do preço.
| Modelo | Preço de entrada ($ / milhão de tokens) | Preço de saída ($ / milhão de tokens) |
|---|---|---|
| GLM 5.2 (zAI) | 1,4 | 4,4 |
| Claude Opus 4.8 (Anthropic) | 5 | 25 |
Uma ressalva, porém: o GLM 5.2 raciocina mais, então consome mais tokens. A Artificial Analysis registra 43.000 tokens por tarefa em média, contra 26.000 na versão 5.1. A economia por token continua grande, mas o volume sobe, e é ele que você precisa acompanhar de perto.
O que o GLM 5.2 muda para as equipes comerciais e de marketing?
Um modelo desse nível a esse preço reduz a barreira de entrada em todos os usos comerciais do dia a dia: enriquecimento de fichas de prospects, qualificação de leads, redação de sequências de prospecção, resumo de chamadas, scoring de oportunidades. Todas essas tarefas repetitivas que rodavam num modelo premium podem passar para o GLM 5.2 sem fazer a conta subir.
O status open weight acrescenta o argumento que os responsáveis de TI e os CIOs do mercado francófono esperavam: hospedar o modelo on-premise, na França, na Bélgica, na Suíça ou em Luxemburgo, em vez de enviar dados de clientes para uma nuvem estrangeira. Vale lembrar: passar pela API chinesa expõe à lei chinesa de inteligência, que pode impor acesso aos dados que trafegam. A hospedagem local elimina esse risco, mas tem um custo.
Em FP8, o modelo pesa quase 900 GB e exige no mínimo oito GPUs Nvidia H100. Conte com uns 400.000 dólares na compra, ou 20.000 dólares por mês no aluguel, segundo Itamar Golan. Versões comprimidas pela Unsloth cabem numa estação de trabalho robusta, desde que você aceite uma perda de qualidade.
O contexto: o bloqueio do Fable 5 e do Mythos 5
A chegada do GLM 5.2 não é por acaso. Em 12 de junho, o Departamento de Comércio dos Estados Unidos ordenou que a Anthropic cortasse o acesso estrangeiro aos seus modelos Fable 5 e Mythos 5 em 48 horas, por motivo de segurança. Os dois modelos foram desativados no mundo inteiro, para todos os clientes. A zAI publicou seu modelo aberto no dia seguinte.
O gesto reacende a corrida entre laboratórios chineses e americanos. O AI Index 2026 de Stanford calcula a diferença entre os melhores sistemas dos dois países em 2,7 pontos percentuais, mesmo que a vantagem americana continue mais nítida nas tarefas de raciocínio mais difíceis. O fundador da zAI, Tang Jie, aliás, contradisse publicamente Elon Musk, que previa um rival chinês do Fable 5 só no início de 2027.
O outro lado da moeda: cuidado com o tokenmaxxing
Um modelo mais barato não dispensa o controle de custos. Um fenômeno cresce nos grandes grupos: o « tokenmaxxing », que consiste em avaliar os funcionários pelo consumo de tokens para forçar a adoção da IA. Amazon, JPMorgan, Meta e Disney teriam criado rankings internos desse tipo. Um funcionário da Disney teria interagido 460.000 vezes com o Claude em nove dias, segundo o Business Insider.
O problema, bem resumido por Logan Wolfe, da Kyndryl: o consumo de tokens não diz nada sobre a produtividade real. Recompensa-se o volume, não o resultado, e a conta sobe enquanto a qualidade estagna. O conselho dos especialistas ouvidos pela CIO cabe em uma frase: acompanhe indicadores de resultado, como o código realmente implantado ou os negócios fechados, em vez do número de tokens queimados. Um modelo a 1,4 dólar o milhão não protege você de nada se cada tarefa consome dez vezes mais do que deveria.
Para as equipes francófonas, o GLM 5.2 não é só uma curiosidade vinda de Pequim. É uma opção real para as tarefas do dia a dia, desde que você enquadre os usos e mantenha um modelo premium à mão para os casos mais pesados. O reflexo certo: teste nos seus próprios casos, calcule o custo por tarefa e decida com base nos fatos.
As perguntas que nos fazem sem parar.
Que pontuação o GLM 5.2 alcança diante dos modelos americanos?
O GLM 5.2 marca 51 pontos de 100 no Intelligence Index da Artificial Analysis, onze a mais que o GLM 5.1 e o melhor resultado de um modelo de pesos abertos. Acima dele, só restam o GPT-5.5 (55) e o Claude Opus 4.8 (56).
Quanto custa o GLM 5.2 em comparação com o Claude Opus?
A zAI cobra 1,4 dólar por milhão de tokens de entrada e 4,4 dólares de saída. A Anthropic pede 5 e 25 dólares pelo Opus. Atenção ao volume: o GLM 5.2 consome 43.000 tokens por tarefa em média segundo a Artificial Analysis, contra 26.000 na versão 5.1.
Dá para hospedar o GLM 5.2 por conta própria?
Sim, o modelo é open weight e pode ser baixado. Em FP8, pesa quase 900 GB e exige no mínimo oito GPUs Nvidia H100, ou seja, uns 400.000 dólares na compra ou 20.000 dólares por mês no aluguel segundo Itamar Golan. Versões comprimidas pela Unsloth cabem numa estação de trabalho robusta, com perda de qualidade.
Quais usos comerciais podem passar para o GLM 5.2?
As tarefas repetitivas do dia a dia que rodavam num modelo premium: enriquecimento de fichas de prospects, qualificação de leads, redação de sequências de prospecção, resumo de chamadas, scoring de oportunidades.
O que é tokenmaxxing?
É avaliar os funcionários pelo consumo de tokens para forçar a adoção da IA. O consumo não diz nada sobre a produtividade real: os especialistas recomendam acompanhar indicadores de resultado, como o código realmente implantado ou os negócios fechados.

O que a comunidade diz.