


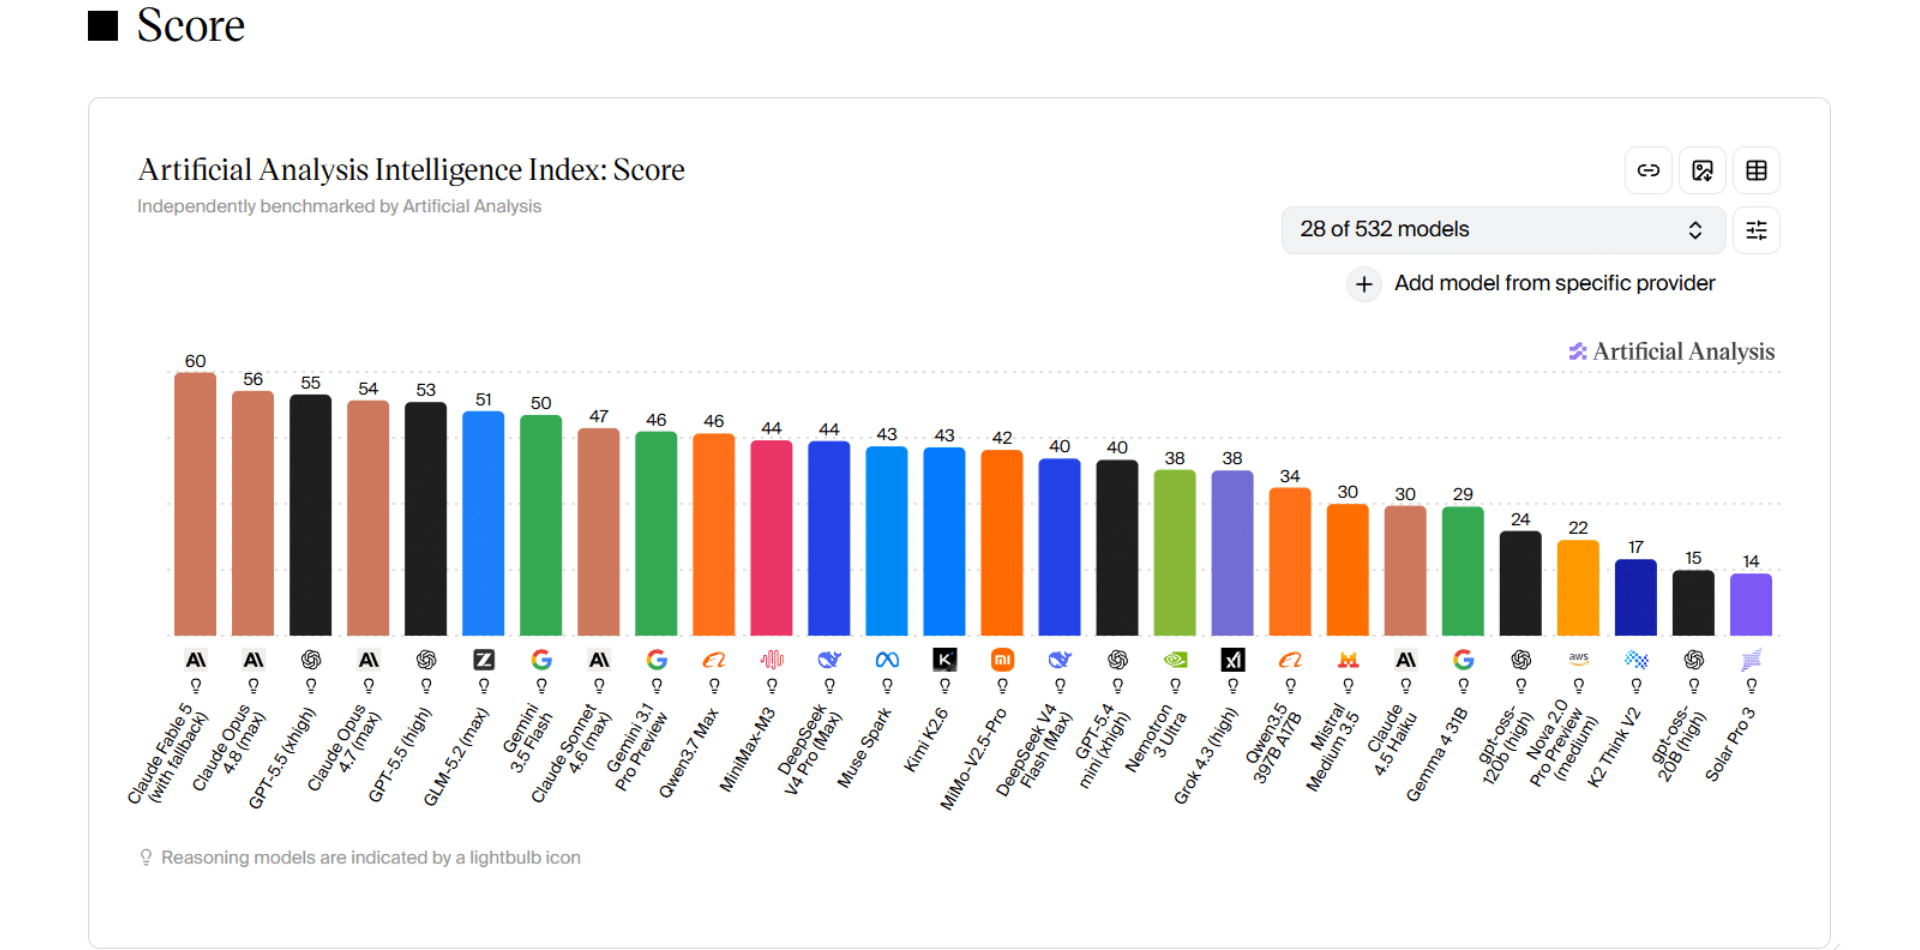
- GLM 5.2 obtiene 51 puntos sobre 100 en el Intelligence Index de Artificial Analysis, el mejor puntaje jamás alcanzado por un modelo open weight, por delante de DeepSeek V4 Pro y Kimi K2.6.
- Se ubica justo detrás de GPT-5.5 (55) y Claude Opus 4.8 (56), por unos 1,4 dólares de entrada y 4,4 dólares de salida por millón de tokens.
- Arquitectura mixture of experts de 744 mil millones de parámetros, ventana de contexto de un millón de tokens, licencia MIT.
- Modelo descargable y alojable on-premise, un argumento de soberanía para las organizaciones francófonas.
- Su llegada sigue al bloqueo por parte de Washington de los modelos Fable 5 y Mythos 5 de Anthropic.
- La otra cara: la carrera por consumir tokens, el «tokenmaxxing», puede descontrolar los presupuestos.
zAI, la startup de Pekín detrás de la familia GLM, lanzó GLM 5.2 a mediados de junio. El modelo es abierto, bajo licencia MIT, y se ubica justo detrás de GPT-5.5 y Claude Opus 4.8 en el benchmark de Artificial Analysis. Todo por un precio diez veces más bajo. Si sigues los presupuestos de IA en un equipo comercial o de marketing francófono, vale la pena mirarlo de cerca: un modelo de este nivel, que se puede descargar y alojar en casa, cambia bastantes cosas.
Un modelo abierto que les pisa los talones a los grandes estadounidenses
En el Intelligence Index de Artificial Analysis, GLM 5.2 obtiene 51 puntos sobre 100. Once más que GLM 5.1, y sobre todo el mejor resultado jamás logrado por un modelo de pesos abiertos. Supera a MiniMax M3 y DeepSeek V4 Pro (44 puntos cada uno), a Kimi K2.6 (43) e incluso a Gemini 3.5 Flash (50). Por encima solo quedan GPT-5.5 (55) y Claude Opus 4.8 (56). Para dar una idea de la distancia, Fable 5 de Anthropic llegaba a 60 antes de ser retirado del mercado.
zAI también reivindica el segundo lugar mundial en el benchmark front-end de Code Arena, detrás solo de Fable 5, según Yellow.com. Itamar Golan, director de Prompt Security, resume bien la impresión de quienes lo probaron: es el primer modelo abierto que no se queda claramente atrás frente a los mejores sistemas propietarios.
744 mil millones de parámetros y un contexto de un millón de tokens
GLM 5.2 retoma la arquitectura mixture of experts de la versión anterior: 744 mil millones de parámetros en total, pero solo 40 mil millones que se activan en cada consulta. Así, la factura de cómputo se mantiene contenida, ya que el modelo nunca moviliza todo su peso para una respuesta.
El verdadero salto es la ventana de contexto. Pasa de 200.000 a un millón de tokens. Suficiente para tragarse de una vez una licitación completa, meses de historial del CRM o toda una base documental. zAI asegura haber entrenado el modelo con contextos largos reales, no solo haber pegado una cifra en la ficha del producto. Una técnica propia llamada IndexShare reduce en un 75 % el costo de indexación de estos contextos extendidos.
El argumento que marca la diferencia: el precio
Aquí es donde se pone interesante para las direcciones que vigilan el gasto. zAI cobra 1,4 dólares por millón de tokens de entrada y 4,4 dólares de salida. Anthropic, por su parte, pide 5 y 25 dólares por Opus. Hablamos de una brecha de uno a cinco, e incluso mayor en la salida.
Wade Foster, CEO de Zapier, corrió el modelo en su propio benchmark, AutomationBench. Su veredicto: GLM 5.2 iguala el mejor puntaje de Opus 4.7 max, por 0,67 dólares por tarea contra 1,80 dólares. Menos de la mitad del precio.
| Modelo | Precio de entrada ($ / millón de tokens) | Precio de salida ($ / millón de tokens) |
|---|---|---|
| GLM 5.2 (zAI) | 1,4 | 4,4 |
| Claude Opus 4.8 (Anthropic) | 5 | 25 |
Un matiz de todos modos: GLM 5.2 razona más, así que consume más tokens. Artificial Analysis registra 43.000 tokens por tarea en promedio, contra 26.000 para la versión 5.1. El ahorro por token sigue siendo amplio, pero el volumen sube, y es eso lo que hay que vigilar.
¿Qué cambia GLM 5.2 para los equipos comerciales y de marketing?
Un modelo de este nivel a este precio baja la barrera de entrada en todos los usos comerciales del día a día: enriquecimiento de fichas de prospectos, calificación de leads, redacción de secuencias de prospección, resumen de llamadas, scoring de oportunidades. Todas esas tareas repetitivas que corrían en un modelo premium pueden pasar a GLM 5.2 sin que suba la cuenta.
El estatus open weight agrega el argumento que esperaban los responsables de TI y los CIO del mercado francófono: alojar el modelo on-premise, en Francia, Bélgica, Suiza o Luxemburgo, en lugar de enviar datos de clientes a una nube extranjera. Hay que tenerlo en cuenta: pasar por la API china expone a la ley china de inteligencia, que puede imponer el acceso a los datos que transitan. El alojamiento local elimina ese riesgo, pero tiene un costo.
En FP8, el modelo pesa cerca de 900 GB y exige como mínimo ocho GPU Nvidia H100. Calcula unos 400.000 dólares para comprarlas, o 20.000 dólares al mes en alquiler, según Itamar Golan. Versiones comprimidas por Unsloth caben en una estación de trabajo potente, siempre que aceptes una pérdida de calidad.
El contexto: el bloqueo de Fable 5 y Mythos 5
La llegada de GLM 5.2 no es casualidad. El 12 de junio, el Departamento de Comercio de Estados Unidos ordenó a Anthropic cortar el acceso extranjero a sus modelos Fable 5 y Mythos 5 en 48 horas, por un motivo de seguridad. Los dos modelos se desactivaron en todo el mundo, para todos los clientes. zAI publicó su modelo abierto al día siguiente.
El gesto reaviva la carrera entre laboratorios chinos y estadounidenses. El AI Index 2026 de Stanford cifra la distancia entre los mejores sistemas de los dos países en 2,7 puntos porcentuales, aunque la ventaja estadounidense sigue siendo más clara en las tareas de razonamiento más difíciles. El fundador de zAI, Tang Jie, además contradijo públicamente a Elon Musk, que no esperaba un rival chino de Fable 5 antes de principios de 2027.
La otra cara de la moneda: cuidado con el tokenmaxxing
Un modelo más barato no te exime de controlar tus costos. Un fenómeno crece en los grandes grupos: el «tokenmaxxing», que consiste en evaluar a los empleados según su consumo de tokens para impulsar la adopción de la IA. Amazon, JPMorgan, Meta y Disney habrían implementado rankings internos de este tipo. Un empleado de Disney habría interactuado 460.000 veces con Claude en nueve días, informa Business Insider.
El problema, bien resumido por Logan Wolfe de Kyndryl: el consumo de tokens no dice nada de la productividad real. Se premia el volumen, no el resultado, y la factura sube mientras la calidad se estanca. El consejo de los especialistas consultados por CIO cabe en una frase: sigue indicadores de resultado, como el código realmente desplegado o los negocios ganados, en lugar de la cantidad de tokens quemados. Un modelo a 1,4 dólares el millón no te protege de nada si cada tarea consume diez veces de más.
Para los equipos francófonos, GLM 5.2 no es solo una curiosidad llegada de Pekín. Es una opción real para las tareas corrientes, siempre que encuadres los usos y tengas a mano un modelo premium para los casos más pesados. El buen reflejo: prueba con tus propios casos, calcula el costo por tarea y decide con datos en la mano.
Las preguntas que nos hacen una y otra vez.
¿Qué puntaje obtiene GLM 5.2 frente a los modelos estadounidenses?
GLM 5.2 obtiene 51 puntos sobre 100 en el Intelligence Index de Artificial Analysis, once más que GLM 5.1 y el mejor resultado de un modelo de pesos abiertos. Por encima solo quedan GPT-5.5 (55) y Claude Opus 4.8 (56).
¿Cuánto cuesta GLM 5.2 en comparación con Claude Opus?
zAI cobra 1,4 dólares por millón de tokens de entrada y 4,4 dólares de salida. Anthropic pide 5 y 25 dólares por Opus. Ojo con el volumen: GLM 5.2 consume 43.000 tokens por tarea en promedio según Artificial Analysis, contra 26.000 para la versión 5.1.
¿Se puede alojar GLM 5.2 en casa?
Sí, el modelo es open weight y descargable. En FP8, pesa cerca de 900 GB y exige como mínimo ocho GPU Nvidia H100, es decir, unos 400.000 dólares de compra o 20.000 dólares al mes en alquiler según Itamar Golan. Versiones comprimidas por Unsloth caben en una estación de trabajo potente, con una pérdida de calidad.
¿Qué usos comerciales pueden pasar a GLM 5.2?
Las tareas repetitivas del día a día que corrían en un modelo premium: enriquecimiento de fichas de prospectos, calificación de leads, redacción de secuencias de prospección, resumen de llamadas, scoring de oportunidades.
¿Qué es el tokenmaxxing?
Es evaluar a los empleados según su consumo de tokens para impulsar la adopción de la IA. El consumo no dice nada de la productividad real: los especialistas aconsejan seguir indicadores de resultado, como el código realmente desplegado o los negocios ganados.

Lo que dice la comunidad.